Author: Linoxyr

  • Maîtrisez la synchronisation d’équipe et l’utilisation des utilitaires lorsque les fumigènes et les explosions interagissent

    Maîtrisez la synchronisation d’équipe et l’utilisation des utilitaires lorsque les fumigènes et les explosions interagissent

    Dans CS2, la fumée n’est plus simplement une couche opaque qui bloque la vision. Il s’agit désormais d’un système volumétrique qui interagit de manière cohérente avec les joueurs, les explosions et le feu, ce qui signifie que le timing, l’espacement et la coordination d’équipe comptent plus que jamais. Pour les équipes compétitives, la valeur tactique de la fumée dépend directement du moment où elle se déploie, de la manière dont elle se superpose aux utilitaires et de la façon dont les adversaires peuvent lire ou contrer cette séquence.

    Ce changement a des implications concrètes pour les joueurs, les analystes et les équipes chargées de l’infrastructure qui accompagnent les environnements compétitifs. Lorsque la fumée et les explosions interagissent de manière prévisible, les équipes peuvent construire des exécutions, des reprises de site et des conversions de fin de round plus fiables autour de fenêtres d’utilisation précises. Dans un jeu où quelques millisecondes suffisent à déterminer si une rotation arrive à temps ou si un site tombe, comprendre ces fenêtres relève de l’infrastructure compétitive, et pas seulement du sens du jeu.

    Pourquoi le timing de la fumée dans CS2 est fondamentalement différent

    Les grenades fumigènes de CS2 sont des objets 3D volumétriques, contrairement à l’ancien modèle statique, et Valve a indiqué que cette amélioration s’étendait aux explosions, au feu, à la fumée, aux flashs de bouche et à d’autres effets. Cela a son importance, car les utilitaires se comportent désormais comme des effets spatiaux partagés plutôt que comme un simple bloqueur visuel activé ou désactivé. Les équipes ne peuvent plus considérer une fumée comme un mur binaire garanti ; elles doivent tenir compte de la manière dont elle occupe l’espace et de la façon dont les autres utilitaires modifient cet espace.

    Liquipedia précise que les grenades fumigènes n’explosent qu’après avoir terminé leur mouvement, ce qui explique pourquoi les lineups et les actions préparées à longue distance reposent sur un timing précis du lancer et de la trajectoire. Si une équipe lance une fumée trop tôt ou trop tard, le reste de l’exécution peut se désynchroniser. Dans le jeu professionnel, cette désynchronisation donne souvent aux défenseurs la seconde supplémentaire dont ils ont besoin pour se repositionner, reprendre leur visée ou reprendre un angle crucial.

    C’est pourquoi il vaut mieux comprendre les utilitaires de CS2 comme un système fondé sur le timing. La fumée elle-même ne constitue pas toute l’action ; elle sert de référence temporelle par rapport à laquelle les autres actions sont mesurées. Les équipes coordonnées sont désormais récompensées pour leur séquençage précis, tandis qu’un mauvais espacement entre les fumigènes et les dégâts qui suivent peut être sanctionné plus efficacement que dans les précédentes versions de Counter-Strike.

    Comment les grenades HE ont changé l’équation de la fumée

    Valve a régulièrement ajusté les interactions entre les grenades HE et la fumée dans CS2, ce qui montre que cette couche d’utilitaires reste un domaine d’équilibrage actif. Une modification documentée a réduit la durée de l’effet des grenades HE sur les fumées, tandis qu’une mise à jour ultérieure a fait en sorte que les explosions de HE à l’intérieur d’une fumée dissipent l’effet accumulé de l’écran de fumée sur les joueurs se trouvant à portée. Ces changements créent des résultats plus cohérents, mais ils rendent également les seuils de timing plus importants pour les deux camps.

    Une mise à jour du 30 mars a ajouté une autre contrainte importante : les grenades HE n’affectent plus les fumées à travers les murs. Cela a un impact direct sur la superposition des utilitaires et sur le timing des attaques contre les regroupements. Avant ce changement, les équipes pouvaient compter sur des interactions indirectes de zone pour faire pression sur une fumée ou sanctionner les joueurs situés à proximité ; désormais, elles ont besoin d’une géométrie plus claire et de meilleures informations sur le moment où les dégâts sont réellement censés atteindre leur cible.

    Le résultat tactique est simple : si votre exécution dépend de l’arrivée d’une grenade avant ou pendant un état de fumée, vous devez planifier autour du moment exact de l’impact. Une HE lancée trop tard peut ne pas provoquer la perturbation souhaitée, tandis qu’une HE lancée trop tôt peut être absorbée par un espacement que les défenseurs avaient déjà anticipé. Au plus haut niveau, ces petites différences déterminent si l’entrée sur un site se déroule proprement ou se transforme en un round bloqué et sans progression.

    Utiliser la fumée comme un outil de timing, pas seulement comme un outil de vision

    L’article de Liquipedia consacré aux grenades fumigènes souligne un point important : la fumée peut être utilisée défensivement pour retarder les poussées et gagner quelques secondes afin de permettre des rotations ou des ajustements sur le site. Cela signifie que la fumée ne sert pas uniquement à bloquer les lignes de vue ; elle permet également de contrôler le rythme du round. Une fumée bien placée peut forcer les attaquants à patienter, à vérifier de nouveau les angles ou à dépenser davantage d’utilitaires avant de s’engager.

    Les conseils de HLTV pour les spectateurs présentent les utilitaires comme un système de contrôle, de déni d’information, de dégâts et de contre-utilitaires, et les équipes les utilisent souvent pour provoquer des rotations avant de frapper l’autre site. Concrètement, une fumée peut servir à créer suffisamment d’incertitude pour pousser les défenseurs à effectuer une rotation excessive. Une fois ces rotations effectuées, l’équipe offensive peut se rabattre sur un site moins défendu ou exploiter une faille dans le cycle d’utilitaires de la défense.

    C’est pourquoi le timing de la fumée est si important dans le CS2 moderne. Une fumée placée trop tôt peut laisser aux défenseurs le temps de s’adapter, tandis qu’une fumée placée trop tard peut arriver après la fermeture de la fenêtre décisive. Les meilleures équipes considèrent la fumée comme un outil qui planifie le déroulement du round, et non comme un objet statique posé sur une ligne.

    Les fenêtres de coordination lors des exécutions et des reprises de site

    HLTV et Liquipedia décrivent tous deux les exécutions professionnelles comme des attaques coordonnées qui utilisent des utilitaires synchronisés pour prendre un site avec une résistance minimale. Cette définition est encore plus stricte dans CS2, car le système de fumée est plus cohérent entre les joueurs et plus sensible à l’espacement. Si un joueur perd le rythme, l’exécution entière peut perdre sa courbe de pression.

    Lors d’une exécution propre, la fumée doit soutenir le timing des flashs, celui de l’entrée et l’espacement après la pose de la bombe. Si la fumée se déploie avant que les flashs soient prêts, les défenseurs peuvent pré-tirer le point d’étranglement. En revanche, si les explosions et les fumées se superposent correctement, l’équipe attaquante peut forcer les défenseurs à prendre des positions défavorables, réduire l’efficacité des tirs croisés et transformer l’entrée en une séquence d’échanges maîtrisable.

    Les reprises de site fonctionnent de la même manière, mais en sens inverse. Les défenseurs qui comprennent le timing de la fumée peuvent utiliser les dégâts des HE, les sorties retardées et les contre-fumées pour reconquérir l’espace selon une séquence structurée plutôt que dans le cadre d’un pari précipité. L’équipe qui comprend en premier la fenêtre d’utilisation des utilitaires remporte généralement la bataille de l’information, ce qui signifie souvent, dans CS2, qu’elle remporte le site.

    Distance, son et couche d’information

    Valve a également apporté des ajustements au timing du son des grenades fumigènes à distance, ce qui rappelle utilement que la fumée n’est pas seulement un mécanisme visuel. Elle fait également partie du jeu de l’information, en influençant la manière dont les équipes interprètent le timing, la distance et le contrôle potentiel de la carte. Si les joueurs entendent différemment les signaux sonores d’une fumée à longue distance, la valeur de ce signal dépend alors de leur position, des autres événements en cours et du fait que le round soit déjà manipulé par une fausse pression.

    Cela a son importance pour les analystes et les entraîneurs, car le timing sonore peut modifier la manière dont une équipe interprète une exécution. Un signal sonore de fumée lointain peut créer un faux sentiment d’urgence ou entraîner une réaction tardive selon la configuration. Associé aux couches d’utilitaires et aux interactions occasionnelles avec les HE, l’aspect sonore de la fumée devient une composante du processus de décision plutôt qu’un simple bruit de fond.

    Dans le jeu coordonné, cela signifie que les équipes doivent analyser non seulement le placement des fumées, mais aussi la séquence exacte dans laquelle elles sont entendues et vues. Plus cette séquence est précise, plus il devient difficile pour les défenseurs de distinguer une véritable attaque d’une feinte basée sur le timing. C’est particulièrement pertinent au niveau professionnel de Counter-Strike, où le contrôle de l’information vaut souvent plus que les dégâts bruts.

    Pression après la pose de la bombe et contrôle de la fin de round

    Liquipedia indique qu’un CT peut toujours désamorcer la bombe en se tenant dans la fumée, ce qui change la manière dont les équipes doivent envisager les utilitaires après la pose. Une fumée ne constitue pas toujours un arrêt complet ; il s’agit parfois seulement d’une couche de dissimulation temporaire qui permet à l’équipe du poseur de se repositionner. Si les défenseurs le comprennent, ils peuvent utiliser le timing, le son et les utilitaires de soutien pour forcer malgré tout le désamorçage.

    Cela fait du timing de la fumée après la pose une compétence essentielle en fin de round. Les équipes doivent souvent synchroniser la durée de la fumée, la pression exercée par les HE et la discipline des tirs croisés afin de rendre tout contact avec la bombe dangereux. Si une fumée se dissipe trop tôt, les défenseurs récupèrent une ligne de vue dégagée. Si elle persiste pendant la tentative de désamorçage critique, elle peut les forcer à prendre une décision risquée, mais uniquement si les attaquants sont positionnés pour la sanctionner.

    Comme les interactions des fumées de CS2 sont plus cohérentes, les équipes peuvent préparer des séquences après-plantation plus fiables. Mais cette cohérence aide également les défenseurs à calculer leurs contres. Le round devient une lutte autour du moment où la fumée se termine, de celui où les dégâts atteignent leur cible et de la capacité de l’équipe attaquante à maintenir un espacement suffisant pour protéger la bombe après le premier contact.

    Ce que les équipes doivent désormais entraîner

    Les équipes doivent travailler les interactions entre fumées et explosions comme un module dédié au timing, et non comme de simples mécaniques d’utilitaires isolées. Cela implique d’analyser les lineups, les fenêtres de dégâts et l’espacement entre la première fumée et la HE ou le flash qui suivent. Il faut également répéter ce qui se passe lorsque l’adversaire casse le rythme en retardant l’action, en tirant à travers la fumée ou en remettant une fumée sur la zone clé.

    Les entraîneurs et les analystes doivent accorder une attention particulière aux exécutions qui ne réussissent que parce que les défenseurs réagissent trop tard. L’analyse Meta Monday de HLTV décrit un round au cours duquel une équipe a lancé ses utilitaires, retardé l’attaque, puis frappé une fois les utilitaires des CT expirés et les rotations éloignées. C’est ce modèle que les équipes doivent étudier : pas seulement une attaque rapide, mais une attaque minutée qui exploite l’épuisement des utilitaires adverses.

    Pour le personnel technique et les organisateurs, le principal enseignement est la cohérence. L’infrastructure compétitive doit garantir des performances serveur stables, une faible latence et un comportement reproductible des utilitaires afin que les équipes puissent faire confiance à leur entraînement. Dans un système où les fumées et les explosions font partie du langage tactique, même de petits délais peuvent fausser l’enseignement tiré d’une situation.

    Les équipes qui maîtriseront ces fenêtres prendront l’avantage aussi bien en attaque qu’en défense. Elles sauront quand patienter, quand forcer un déplacement et quand utiliser la fumée comme un outil de timing plutôt que comme un simple objet de couverture. Dans CS2, cette distinction est désormais essentielle pour remporter les rounds.

    La leçon générale est que les fumées et les explosions ne sont plus des éléments distincts dans le Counter-Strike compétitif. Elles sont liées au sein d’un réseau de timing qui définit la manière dont se déroulent les exécutions, les reprises de site et les phases après la pose de la bombe. Les équipes qui intègrent ce réseau prendront de meilleures décisions sous pression, tandis que les autres continueront de réagir à des utilitaires qu’elles n’ont pas réussi à synchroniser.
  • Trouvez des partenaires fiables pour former une équipe de cinq après la refonte du classement de Valve

    Trouvez des partenaires fiables pour former une équipe de cinq après la refonte du classement de Valve

    La mise à jour VRS de Valve, fin septembre 2026, a bouleversé bien plus que les feuilles d’invitation. Elle a également mis en évidence l’instabilité croissante de l’écosystème compétitif pour les équipes qui tentent de constituer des cinq majeurs fiables dans l’environnement actuel du classement. Lorsque l’accès aux tournois dépend du dernier instantané des classements régionaux de Valve, la disponibilité des joueurs, la formation des équipes et même le choix des partenaires d’entraînement commencent à revêtir une importance plus opérationnelle.

    Pour les équipes d’eSport, les ingénieurs de plateformes et les organisateurs de compétitions, la question pratique n’est plus seulement de savoir qui est suffisamment fort pour jouer des entraînements. Il s’agit de déterminer qui peut rester éligible, lancer des files d’attente correctement et rester constant dans un système de classement qui influence à la fois la logique des invitations de haut niveau et le fonctionnement quotidien du matchmaking Premier.

    Pourquoi le bouleversement du classement a changé la préparation des cinq majeurs

    HLTV a rapporté que la mise à jour VRS tardive du 8 septembre 2026 de Valve avait semé le chaos chez les organisateurs de tournois, car les décisions d’invitation dépendent de l’instantané VRS le plus récent au moment de l’attribution. Cela dépasse largement le simple tableau des invitations. Lorsque le système qui contrôle l’accès à BLAST Rivals, au PGL Bucharest 2027 et au PGL Major Singapore 2027 continue d’évoluer, les managers et analystes d’équipe doivent adopter une approche plus rigoureuse pour sélectionner des partenaires capables de jouer régulièrement à cinq.

    Selon l’instantané de HLTV du 22 septembre, les meilleures équipes européennes au classement VRS comprenaient Spirit, Falcons, MOUZ, FUT et The MongolZ. Cette volatilité au sommet révèle une réalité plus générale : le vivier de partenaires fiables évolue rapidement, et les équipes qui semblaient stables une semaine plus tôt ne sont peut-être plus les meilleurs choix à long terme pour les files d’attente ou les entraînements.

    Dans cet environnement, la constitution d’un cinq majeur doit être considérée comme une planification d’infrastructure. Il ne s’agit pas seulement de rechercher des compétences brutes, mais des équipes dont la disponibilité est prévisible, le comportement en matière de classement stable et le lien avec le cycle compétitif actuel piloté par le VRS clairement établi.

    Faites du statut Prime votre premier filtre

    Le support Steam est explicite : les joueurs gratuits de CS2 peuvent accéder à la plupart des modes, mais le mode Premier nécessite le statut Prime. Cela suffit à faire de Prime le premier filtre incontournable lorsque vous cherchez des partenaires fiables pour jouer à cinq après ce bouleversement. Si votre groupe est partagé entre joueurs Prime et non-Prime, vous introduisez déjà de l’inconstance dans l’accès, la qualité des files d’attente et les attentes liées au matchmaking.

    Valve précise également que les groupes mixtes Prime et non-Prime peuvent jouer ensemble, mais que le lobby est alors considéré comme non-Prime et associé en conséquence. Pour les organisateurs et les responsables d’équipe, cela crée un risque opérationnel évident : un seul participant non-Prime peut dégrader l’environnement de matchmaking du lobby et fausser les conditions d’entraînement prévues.

    En pratique, les groupes exclusivement Prime sont plus faciles à standardiser, à contrôler et moins susceptibles de subir des perturbations évitables dans les files d’attente. Si votre objectif est la fiabilité, ne considérez pas Prime comme un simple avantage. Faites-en une exigence de base.

    Associez des tranches de classement similaires, pas seulement des ambitions similaires

    La communauté continue de signaler des restrictions liées aux écarts de rang en Premier ainsi que des variations de classement dans les files d’attente à cinq, notamment lorsque les joueurs tentent de jouer avec de grandes différences de classement. Même si les seuils exacts varient selon les mises à jour et les situations, la leçon opérationnelle reste la même : une grande dispersion des niveaux au sein d’un groupe produit généralement des résultats de matchmaking instables et une évolution irrégulière du classement.

    Des discussions récentes sur Steam montrent également que des joueurs décrivent de fréquentes variations de classement à la hausse ou à la baisse dans les environnements à cinq. Le choix des partenaires devient donc plus qu’une décision sociale. Il s’agit d’une décision d’ingénierie visant à contrôler la variance. Si les classements de votre groupe sont trop dispersés, vous augmentez le risque de déséquilibre, de tilt et de progression irrégulière.

    L’approche la plus sûre consiste à privilégier des joueurs ou des équipes de niveau similaire appartenant à la même tranche compétitive. Cela ne signifie pas que les niveaux doivent être identiques, mais qu’une certaine parité doit être prévisible. Les partenaires fiables pour jouer à cinq sont ceux dont l’écart de classement n’oblige pas le système de matchmaking à effectuer de trop lourdes compensations.

    Privilégiez les équipes ayant une activité stable et un historique de matchmaking irréprochable

    Le système Trust Factor de Valve utilise plusieurs signaux, notamment les numéros de téléphone et le rang dans Counter-Strike 2, et récompense explicitement le jeu légitime. Le profil d’activité compte donc autant que les compétences brutes. Un cinq majeur qui joue régulièrement, évite les comportements perturbateurs et conserve une intégrité de compte constante offrira généralement un meilleur partenariat à long terme qu’un groupe plus fort, mais irrégulier.

    Les équipes ayant des plannings actifs permettent également de résoudre un problème majeur de coordination : elles sont plus faciles à réunir. La fiabilité ne concerne pas uniquement les performances en jeu. Elle dépend aussi de la capacité du groupe à être présent à l’heure, à conserver le même effectif et à éviter les remplacements de dernière minute qui modifient la qualité de la file d’attente.

    Si vous constituez un réseau de partenaires, recherchez des équipes ayant un rythme de jeu défini, une gestion stable de leur effectif et aucun signal d’alerte évident en matière de matchmaking. Dans un contexte VRS volatil, la régularité devient un avantage compétitif, car elle réduit le nombre de variables incontrôlées.

    Évitez les pratiques de boosting et les lobbies aux objectifs divergents

    Les signalements d’abus de boosting en cinq majeur restent nombreux en 2026, certains joueurs décrivant l’utilisation de comptes de faible rang pour faire progresser des coéquipiers mieux classés. Ce comportement peut améliorer temporairement les résultats de classement de certains participants, mais il nuit à l’équité du matchmaking et fait de ces lobbies de mauvais partenaires à long terme pour les équipes sérieuses.

    D’un point de vue tactique, les groupes fortement associés au boosting sont peu fiables, car leur comportement dans les files d’attente ne repose pas sur l’intégrité compétitive. Ils peuvent fausser l’évolution des rangs, créer une qualité de confrontation inégale et introduire des risques liés aux comptes qu’aucune équipe organisée ne devrait accepter dans son environnement d’entraînement ou de préparation.

    Si la réputation d’un groupe laisse penser qu’il utilise le matchmaking comme un moyen d’exploiter le classement plutôt que comme un environnement d’entraînement, excluez-le. Les partenaires fiables pour jouer à cinq ne sont pas synonymes de partenaires pratiques pour jouer à cinq. Les premiers préservent la qualité de la compétition ; les seconds la dégradent généralement.

    Suivez l’évolution du VRS lorsque vous choisissez des partenaires pour préparer votre équipe

    Les archives d’actualité de HLTV pour septembre 2026 montrent que les résultats des tournois ayant un impact sur le classement continuent de faire évoluer le paysage VRS d’une semaine à l’autre. Cela compte, car votre vivier de partenaires est indirectement façonné par les mêmes mouvements compétitifs que ceux qui contrôlent l’accès aux invitations. Les équipes qui progressent au classement disposent souvent d’une meilleure discipline en matière de calendrier et de structures plus claires, tandis que celles qui sortent de la course peuvent devenir moins disponibles ou moins motivées.

    C’est particulièrement important pour les organisations qui utilisent des cinq majeurs externes comme partenaires d’entraînement. Une équipe partenaire qui change ses membres principaux, se concentre sur d’autres ladders ou se tourne vers des campagnes de qualification peut cesser d’être une option stable avec très peu de préavis. Après le bouleversement du classement de Valve, la durée de vie du statut de « bon partenaire » est plus courte.

    Pour cette raison, tenez une liste de suivi interne des équipes actives, classées par région, tranche de classement et disponibilité récente. L’objectif n’est pas de poursuivre les équipes en tête du classement VRS, mais d’identifier des groupes suffisamment constants pour permettre des parties répétées et réellement utiles.

    Établissez une liste de partenaires selon des critères opérationnels

    Le processus de sélection le plus fiable repose sur un modèle de notation simple. Commencez par le statut Prime, filtrez ensuite selon la proximité des classements, vérifiez la fréquence d’activité et examinez enfin l’historique comportemental. Si un partenaire potentiel échoue à l’une de ces étapes, il ne doit pas faire partie de votre rotation habituelle de cinq majeurs.

    Cette approche aide également les rédacteurs de contenu, les analystes et les équipes techniques à expliquer pourquoi un partenaire est préféré à un autre. Dans un écosystème guidé par le VRS, les décisions doivent pouvoir être justifiées. Vous devez être en mesure de vous appuyer sur des critères objectifs tels que le statut du compte, la régularité des files d’attente et la stabilité attendue du classement.

    Une bonne liste de partenaires reste généralement réduite. Trois à cinq équipes partenaires fiables valent souvent mieux qu’une longue liste d’options irrégulières. Plus la liste est courte, plus il est facile de maintenir des standards et moins votre équipe passe de temps à résoudre des problèmes de matchmaking évitables.

    Rendez votre cinq majeur résilient, pas seulement fort

    La leçon à tirer de ce bouleversement est simple : la fiabilité compte désormais autant que le niveau compétitif. Le système de classement de Valve est le gardien officiel de nombreuses opportunités de tournoi, et ce même écosystème influence l’expérience des joueurs dans les files Premier. Le choix des partenaires devient donc une décision structurelle, et non plus une décision prise à la légère.

    Les équipes qui privilégient une participation exclusivement Prime, des tranches de classement proches, une activité régulière et un jeu légitime créeront l’environnement à cinq le plus stable. En pratique, cela signifie de meilleures files d’attente, des données d’entraînement plus propres et moins de surprises lorsque le matchmaking ou le classement VRS évoluera à nouveau.

    Si vous reconstruisez votre réseau de partenaires après les changements de Valve, donnez d’abord la priorité à la prévisibilité. Les partenaires forts sont utiles. Les partenaires forts et fiables sont ceux qui permettent réellement à une équipe de rester compétitive.

  • Affinez les tactiques de l’équipe grâce aux marqueurs de chronologie, à l’analyse des démonstrations et à la rédaction de scripts d’atelier

    Affinez les tactiques de l’équipe grâce aux marqueurs de chronologie, à l’analyse des démonstrations et à la rédaction de scripts d’atelier

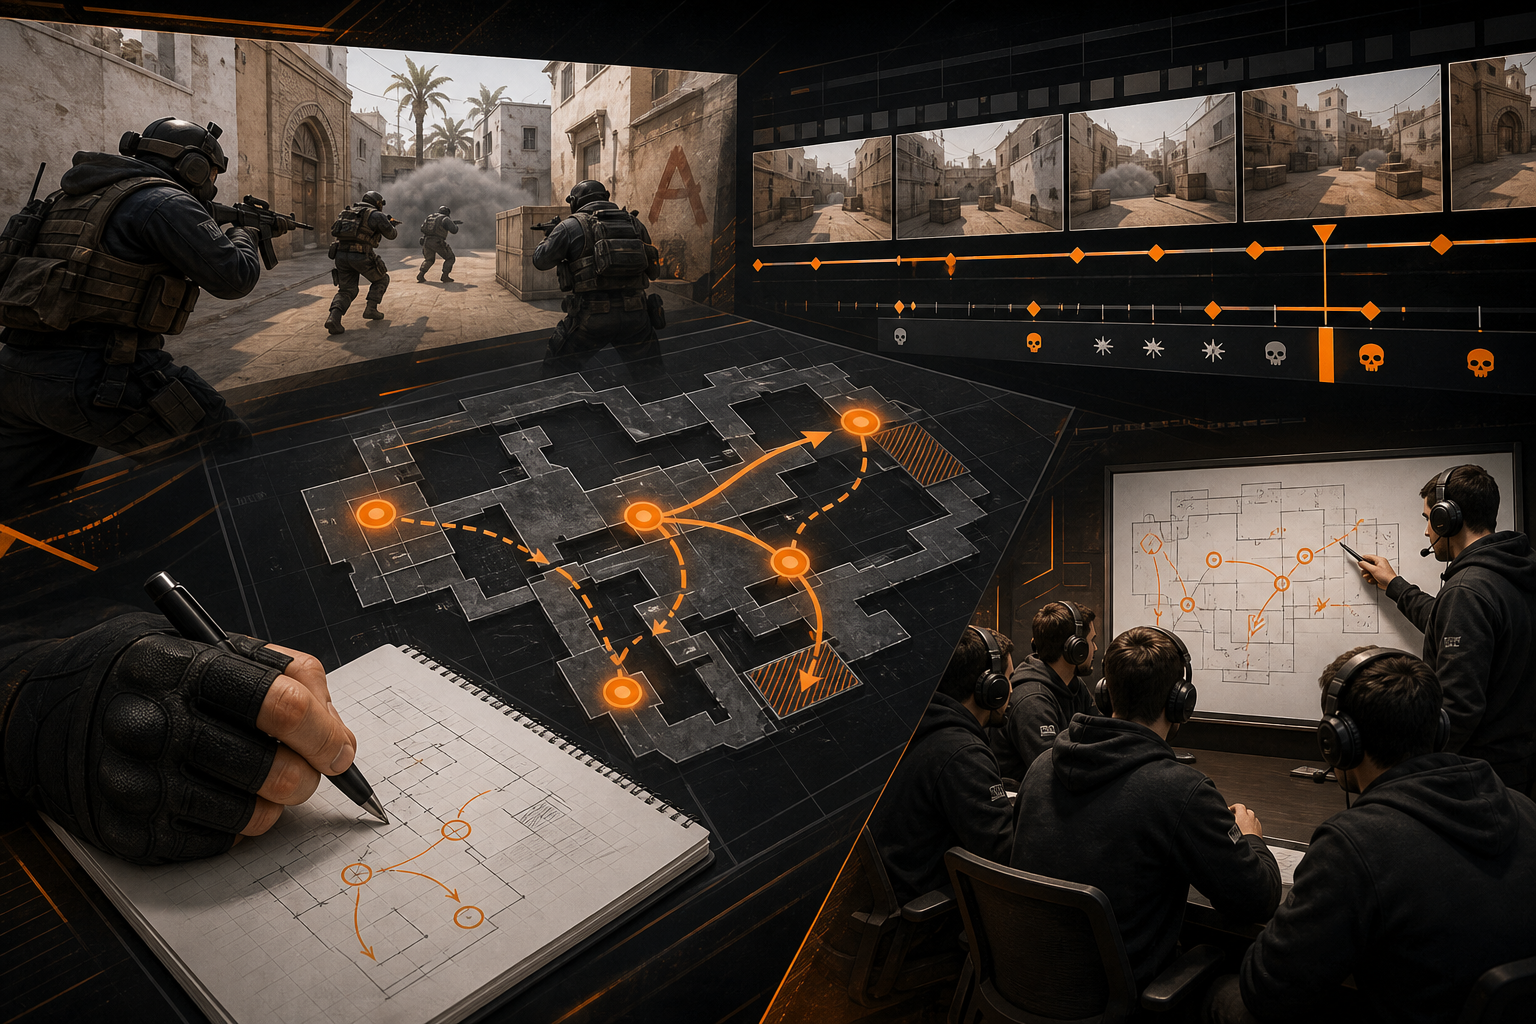
    Les équipes compétitives parlent souvent de « problèmes de communication » ou de « mauvaises lectures » lorsqu’une semaine de match ou un sprint déraille, mais cette manière de présenter les choses est généralement trop vague pour être utile. En pratique, il est plus constructif de reconstituer la suite des événements, d’aborder la revue de la démo comme une conversation et de transformer l’atelier en procédure opérationnelle reproductible. Cette combinaison offre aux équipes une meilleure façon de comprendre ce qui s’est réellement passé avant de commencer à débattre de ce qui aurait dû se passer.

    Pour les équipes d’eSports, les ingénieurs plateforme et les équipes chargées des compétitions, cette démarche est importante, car les problèmes de timing, de dépendances et de décisions sensibles à la latence surviennent rarement de manière isolée. Une rétrospective chronologique peut révéler à quel moment le lancement a pris du retard, quand une modification du serveur a été déployée, quand une démo a mis au jour une incohérence ou quand un changement d’effectif a modifié la nature du travail. Une fois ces moments rendus visibles, la revue de démo et la préparation de l’atelier peuvent aider l’équipe à passer de la recherche de responsables à des actions précises et vérifiables.

    Commencer par la chronologie, pas par les opinions

    La première étape de toute rétrospective utile consiste à reconstituer la suite des événements dans l’ordre. Une rétrospective chronologique y parvient en plaçant les jalons de gauche à droite afin que l’équipe puisse s’aligner sur le lancement, la démo, les incidents, les changements d’effectif et les évolutions des exigences avant de débattre des solutions. Cette séquence est importante, car la mémoire est rarement neutre sous pression, en particulier après une panne, une mauvaise version ou une journée de tournoi ratée.

    Lorsque les équipes ajoutent des repères chronologiques, une frustration vague devient concrète. Au lieu de dire « le réseau était instable », le groupe peut déterminer précisément quand la perte de paquets a commencé, quel entraînement ou quel déploiement a été affecté et ce qui avait changé juste avant l’apparition du problème. Cette précision permet de discuter de la causalité et réduit la tendance habituelle à rejeter la faute sur des souvenirs incertains.

    Cette approche est particulièrement utile dans les activités à forte variabilité, comme les mises en production marquées par de nombreux incidents, les opérations de grands tournois et les changements d’infrastructure en direct. SprintPulse souligne qu’une rétrospective fondée sur une chronologie peut être plus adaptée qu’une simple session Plus/Delta lorsque l’équipe a connu un incident grave. Dans ces situations, la chronologie elle-même constitue l’artefact qui maintient l’honnêteté de la discussion.

    Utiliser des repères chronologiques pour révéler les dépendances

    Les repères chronologiques ne servent pas uniquement à étiqueter les événements ; ils révèlent également les dépendances entre les équipes et les systèmes. Le guide d’Atlassian consacré aux rétrospectives présente les chronologies comme un moyen de garder les équipes et les parties prenantes synchronisées, en affichant les mises en production, les éléments de travail et les dépendances dans une même vue. Pour les opérations de jeu compétitif, cette vue partagée peut inclure les déploiements de code, les mises à jour des règles, les changements apportés aux outils d’observation et les échéances liées au contenu.

    Un ensemble de repères bien conçu aide également les équipes à comparer le déroulement prévu au déroulement réel. Un article de 2026 consacré aux rétrospectives recommande d’examiner le périmètre initial et les critères de réussite en parallèle de ce qui a effectivement été livré. Cette comparaison est importante, car un projet peut sembler « dans les temps » pendant les réunions tout en s’éloignant des conditions censées définir sa réussite dès le départ.

    Les transmissions entre équipes bénéficient elles aussi de cette approche. Lorsque les équipes support, infrastructure et contenu se réfèrent toutes à la même séquence, elles peuvent localiser le point de rupture de la transmission au lieu de revenir sur chaque conversation précédente. La chronologie devient ainsi un outil de coordination, et pas seulement un support visuel de réunion.

    Reconstituer le sprint ou l’événement comme une rediffusion

    Les rétrospectives récentes utilisent de plus en plus la « rediffusion chronologique » pour faire apparaître des tendances que les réunions quotidiennes ne permettent pas de voir. L’idée de base est simple : reconstituer le sprint ou l’événement dans l’ordre chronologique et laisser les données raconter l’histoire, jour après jour. Cette approche fonctionne bien dans les opérations d’eSports, où une chaîne de petites décisions peut produire un effet considérable en aval sur la latence, la préparation ou l’équité de la compétition.

    Les listes de jalons chronologiques sont désormais un support d’atelier courant pour cette raison précise. Une séquence pratique peut comprendre le lancement, les décisions d’architecture, la première démo, l’intégration, les tests, la mise en production et la première semaine en production. Dans un environnement de tournoi ou de service en direct, le même modèle peut être adapté aux répétitions, au provisionnement des serveurs, à la validation du jour de match, à la réponse aux incidents et à la stabilisation post-événement.

    Certains scripts plus récents ajoutent même une évaluation à chaque jalon, en indiquant les moments positifs, neutres et négatifs sur la chronologie. Cette légère couche de notation aide l’équipe à identifier les moments qui méritent une analyse plus approfondie sans transformer l’exercice en jugement subjectif sur l’ensemble du projet. C’est une manière simple de séparer les signaux du bruit.

    Faire de la revue de démo une véritable conversation de feedback

    La revue de démo ne doit pas être considérée comme une présentation soignée au cours de laquelle les parties prenantes assistent passivement à une révélation. Le guide Disciplined Agile du PMI explique clairement qu’une démo produit est une conversation avec les parties prenantes sur ce qui a été réalisé et sur la suite à donner. Cette approche modifie l’objectif de la réunion : il ne s’agit pas de faire une performance, mais de parvenir rapidement à un alignement.

    Pour les équipes qui cherchent à réduire les reprises, les démos précoces sont plus utiles que les démos tardives. Le PMI insiste sur le fait qu’il vaut mieux faire une démo tôt et recevoir rapidement des retours constructifs que découvrir plus tard des incohérences qui se transformeront en dette technique. Dans le domaine du jeu compétitif, cela peut signifier présenter une interface, un flux de travail ou un comportement serveur alors qu’il est encore temps d’ajuster la conception avant que les contraintes du jour de match ne la figent.

    La cadence des démos doit également rester flexible. Le PMI indique que les démos peuvent avoir lieu dès qu’une fonctionnalité ou une user story est prête et que les parties prenantes sont disponibles, plutôt que d’être systématiquement liées aux limites d’une itération. Cette flexibilité est utile lorsqu’une fonctionnalité atteint un point de contrôle important ou lorsqu’un problème d’exploitation en direct nécessite rapidement l’avis des parties prenantes avant la prochaine revue prévue.

    Préparer la démo pour que les travaux complexes restent visibles

    Les démos impliquant plusieurs personnes fonctionnent mieux lorsque leur déroulement est scénarisé. Le manuel de GitLab recommande au responsable de la démo de diviser le résultat attendu en étapes procédurales plus petites et de les consigner comme étapes de démo. Cette pratique rend la démo reproductible, facilite sa transmission et réduit le risque de perdre le fil lorsque plusieurs personnes y participent.

    Il est tout aussi important de désigner un DRI pour chaque volet de la démo. Le processus de GitLab demande à un responsable de l’équipe fonctionnelle de prendre en charge chaque volet afin d’éviter le problème classique : « tout le monde est responsable, donc personne ne l’est ». Dans un environnement eSports ou plateforme distribué, cette clarté des rôles évite que la démo ne devienne une suite de suppositions.

    La préparation structurée des démos améliore également la présentation des travaux à haut risque ou fortement liés à l’infrastructure. Si le volet comprend l’observabilité, la latence, l’orchestration des matchs ou le comportement en cas de restauration, un déroulement scénarisé garantit que le public voit les points de contrôle précis qui comptent. C’est bien plus utile qu’une visite générique d’écrans et de tableaux de bord.

    Construire le script de l’atelier autour de la responsabilité

    Les recommandations modernes en matière de rétrospectives considèrent de plus en plus la responsabilité comme un élément à intégrer à la conception de l’atelier, plutôt que comme quelque chose que l’on espère voir apparaître par la suite. Un guide de 2026 consacré aux rétrospectives indique que le résultat devrait être constitué d’une à trois actions, avec des responsables et des dates d’échéance, et que les actions de la rétrospective précédente devraient être examinées au début de la session suivante. Cela crée une continuité et évite que les rétrospectives ne deviennent un cycle d’enseignements sans suivi.

    Un autre guide récent présente le suivi des actions comme un contrat plutôt que comme une liste de contrôle. Cette distinction est importante, car une liste de contrôle laisse entendre que l’exécution est facultative, tandis qu’un contrat rend l’engagement visible pour le groupe. Limiter la durée de chaque partie de l’atelier renforce cette discipline en aidant l’équipe à passer de la revue à l’analyse, puis à l’action, sans s’attarder trop longtemps sur une seule phase.

    Les kits récents regroupent de plus en plus le format, le script de l’animateur et le suivi des actions pour cette raison précise. Le kit de démarrage de The Hunger Engine, par exemple, associe un format de rétrospective à un script d’animation et à un suivi des actions afin que les engagements soient consignés et réexaminés. L’effet concret est un atelier qui produit des décisions, et pas seulement des discussions.

    Préserver la sécurité psychologique tout en restant direct

    Un atelier scénarisé ne doit pas sembler rigide ou punitif. Les recommandations de GoalPath destinées aux animateurs sont utiles à cet égard, car elles avertissent que les formulations prudentes, les esquives ou l’évitement peuvent indiquer que l’environnement ne semble pas suffisamment sûr pour permettre un feedback honnête. Si les participants adoucissent chacune de leurs remarques, le script peut être techniquement complet, mais socialement inefficace.

    L’animateur doit donc rendre le processus direct sans le rendre hostile. Les repères chronologiques sont utiles, car ils éloignent la conversation des jugements généraux pour la rapprocher de moments observables. Au lieu de demander qui a échoué, l’animateur peut demander ce qui s’est passé à un moment précis, quels signaux étaient disponibles et quelle décision a modifié le résultat.

    Une chronologie partagée peut également renforcer l’identité collective, et pas seulement l’analyse. L’activité de 2026 de Naboo, consacrée à la chronologie d’une équipe, reconstitue les moments clés de l’histoire du groupe sur une frise visuelle, soulignant la valeur d’un contexte partagé. Le même principe s’applique aux rétrospectives : lorsque les participants s’accordent sur la séquence, ils sont plus susceptibles de discuter du travail plutôt que de défendre leur propre souvenir.

    Adapter la méthode aux incidents, aux mises en production et aux opérations en direct

    Tous les ateliers n’ont pas besoin de la même structure. Les rétrospectives fondées sur une chronologie sont particulièrement efficaces lorsque l’équipe a connu un incident grave, une mise en production à forts enjeux ou une perturbation le jour d’un match, dans des situations où l’ordre des événements compte davantage que le ressenti général. Dans ces cas, l’équipe doit donner la priorité à ce qui s’est passé, au moment où cela s’est produit et à ce qui avait changé immédiatement avant le point d’échec ou de réussite.

    Cette adaptation est particulièrement pertinente dans le cadre des activités d’infrastructure en direct. Une hausse de latence, un service mal configuré ou une évolution tardive des exigences interagit souvent avec l’effectif et le calendrier des déploiements d’une manière qu’il est facile de manquer lors d’une discussion standard. Une rétrospective chronologique aide à isoler ces interactions avant qu’elles ne se transforment en schémas répétitifs.

    La même logique s’applique à la revue de démo dans des environnements proches de la production. Si une démo de fonctionnalité révèle une lacune d’intégration, l’équipe doit consigner cet événement dans la chronologie au lieu de le traiter comme une surprise isolée. La rétrospective gagne ainsi en utilité, car elle relie le résultat de la démo à la chaîne opérationnelle qui l’a produit.

    Boucler la boucle grâce à un suivi visible

    Le meilleur script de rétrospective ou d’atelier se termine par des engagements qui pourront être vérifiés ultérieurement. C’est pourquoi les recommandations récentes les plus solides préconisent de conclure par des actions engagées, des responsables et des dates d’échéance, plutôt que de laisser l’équipe avec de simples observations. Sans mécanisme de suivi, la chronologie devient un compte rendu historique plutôt qu’un outil de pilotage.

    Une conclusion claire facilite également l’organisation de la session suivante. Examiner les actions précédentes au début de la prochaine rétrospective crée une continuité et permet à l’équipe de mesurer si les changements convenus ont réellement influencé le sprint, l’événement ou la mise en production suivants. Cette discipline est particulièrement précieuse dans les opérations d’eSports, où des problèmes récurrents peuvent se dissimuler derrière des compositions d’équipe changeantes et des cycles événementiels courts.

    En définitive, les repères chronologiques, la revue de démo et la préparation des ateliers résolvent le même problème sous des angles différents : ils rendent les travaux complexes visibles, discutables et soumis à la responsabilité de chacun. Lorsque les équipes reconstituent les événements chronologiquement, considèrent les démos comme des conversations de feedback et structurent l’atelier autour de responsabilités explicites, elles remplacent les suppositions par une clarté opérationnelle. C’est le fondement de meilleures tactiques, d’une réduction des reprises et d’une adaptation plus rapide sous pression.

    Pour les équipes qui travaillent dans le jeu compétitif et l’infrastructure en direct, cette clarté n’est pas une surcharge administrative. Elle fait partie de la chaîne de performance. Mieux l’équipe comprend ce qui s’est passé, plus vite elle peut affiner la manière dont elle agira la prochaine fois.

  • Comment QuickFrag simplifie la création d’une équipe de cinq joueurs, des profils vérifiés aux entraînements instantanés

    Comment QuickFrag simplifie la création d’une équipe de cinq joueurs, des profils vérifiés aux entraînements instantanés

    Construire un cinq fiable sur CS2 relève surtout d’un problème de système déguisé en problème social. La difficulté est rarement de trouver cinq joueurs ; elle consiste plutôt à coordonner les identités, les emplois du temps, l’accès aux serveurs, les paramètres des matchs et le débriefing d’après-match sans transformer chaque soirée de scrim en travail administratif.

    QuickFrag s’articule précisément autour de ce flux de travail. En combinant des profils Steam vérifiés, la gestion des rosters, l’hébergement de scrims privés et l’analyse des démos sur une seule plateforme, le service réduit le nombre d’outils dont une équipe a besoin pour maintenir une unité de cinq joueurs active et régulière.

    Des profils vérifiés pour établir une base fiable

    Tout cinq sérieux a besoin d’une couche d’identité fiable avant de pouvoir être considéré comme une équipe. QuickFrag exige une authentification Steam, ce qui signifie que les identités des joueurs sont vérifiées plutôt qu’improvisées, et que les statistiques associées à ces profils ont moins de risques d’être faussées par des comptes jetables ou des remplaçants non suivis.

    Cela a une importance opérationnelle. Lorsque les décisions concernant le roster dépendent des performances, de la présence et de la régularité, la plateforme doit conserver un historique stable indiquant qui a joué, comment et à quelle fréquence. Le système de profils de QuickFrag est conçu pour cela, avec une identité persistante, le rang, l’ELO, l’historique des matchs, les statistiques, les succès, la progression, l’inventaire et l’activité conservés d’une session à l’autre.

    Pour le staff, cela réduit la quantité de vérifications manuelles habituellement nécessaires avant un scrim ou une session de test. Au lieu de comparer des noms dans Discord et des tableurs, les organisateurs peuvent s’appuyer sur des profils authentifiés et un historique commun qui suit le joueur au fil des matchs.

    La gestion du roster et le recrutement au même endroit

    QuickFrag ne traite pas le recrutement comme un processus administratif séparé. Sa page consacrée aux équipes indique qu’elles peuvent gérer leur roster, recruter des joueurs et lancer des scrims privés depuis le même environnement, ce qui est important pour les cinq qui sont encore en phase de stabilisation ou qui alternent régulièrement les remplaçants.

    Cette intégration change la manière dont un cinq se forme. Un capitaine peut suivre les joueurs déjà présents dans le roster, repérer les éventuels manques en matière de rôles et intégrer de nouveaux joueurs au processus sans passer d’un canal de recrutement à des documents partagés, puis à des outils de scrim distincts. Le résultat est une réduction des frictions entre le recrutement et l’entraînement.

    C’est particulièrement utile pour les équipes d’entraînement et les communautés Discord qui font tourner leurs participants. La communication produit allemande de QuickFrag positionne explicitement la plateforme autour de la création coordonnée de matchs et de profils de joueurs structurés pour les groupes d’amis, les équipes d’entraînement et les organisateurs de scrims, ce qui facilite le traitement du cinq comme une unité permanente plutôt que comme une file d’attente improvisée.

    La mise à disposition instantanée des serveurs supprime le principal obstacle à la planification

    Le moyen le plus rapide de gâcher une soirée de scrim est de passer les 20 premières minutes à chercher un serveur. La promesse centrale de QuickFrag est de pouvoir mettre à disposition des serveurs CS2 dédiés pour des scrims privés en 5 contre 5 en moins de 60 secondes, ce qui change considérablement le rythme des entraînements d’équipe.

    Cette rapidité compte, car les sessions en cinq sont généralement limitées dans le temps. Si une équipe ne dispose que de quelques heures, chaque minute passée à configurer des adresses IP, à se connecter à une infrastructure louée ou à attendre la fin de la configuration d’un hôte réduit le temps réellement consacré à l’entraînement. Le modèle de QuickFrag est conçu pour éliminer ce temps mort.

    Il facilite également l’organisation de matchs fermés à 10 joueurs et de soirées en cinq sans nécessiter la location d’un VPS ni l’exposition d’un réseau partagé. En conservant une mise à disposition interne et à la demande, la plateforme supprime une couche de gestion de l’infrastructure qui revient généralement aux ingénieurs de la plateforme ou au joueur le plus à l’aise techniquement dans le roster.

    Les scrims privés offrent un environnement d’entraînement contrôlé

    Les salons privés sont l’endroit où un cinq cesse de se comporter comme une simple file d’attente occasionnelle et commence à fonctionner comme une véritable unité. La page des fonctionnalités de QuickFrag indique que les salons privés CS2 sont conçus pour les scrims, les soirées en cinq et les matchs fermés, ce qui rend la plateforme adaptée à un entraînement contrôlé plutôt qu’au seul matchmaking public.

    La valeur ajoutée réside ici dans la régularité opérationnelle. Les équipes peuvent réutiliser les mêmes paramètres, les mêmes règles et la même structure de match tout en gardant les équipes extérieures à l’écart de la session. QuickFrag présente explicitement cela comme un moyen d’héberger des matchs sans louer de VPS ni partager d’adresses IP, deux problèmes récurrents pour les petites équipes.

    Les scrims privés offrent également aux organisateurs une manière plus claire de gérer la présence et la préparation. Lorsque la session se déroule déjà dans un environnement fermé de 10 joueurs, il est plus facile de confirmer qui est présent, qui remplace un titulaire et de quel côté chaque joueur doit commencer avant le début de la première manche.

    Des paramètres de match structurés transforment les groupes occasionnels en entraînements réguliers

    Un cinq progresse plus rapidement lorsque chaque session suit un format prévisible. QuickFrag met l’accent sur des paramètres de compétition structurés tels que les règles MR15, le vote de carte et le suivi des résultats, des contrôles qui rendent les scrims utiles au développement plutôt que de simples parties d’échauffement.

    Le matchmaking public est également présenté comme un moyen rapide d’accéder à un serveur compétitif en 5v5, avec une mise à jour de l’ELO enregistrée sur le profil du joueur après chaque partie. Cela apporte une dimension de progression à la plateforme, même lorsque le groupe ne joue pas un scrim privé, et aide les joueurs à suivre l’évolution du cinq au fil du temps.

    Pour le staff et les analystes, le point important est que le match n’est pas seulement joué : il est enregistré de manière à pouvoir être consulté à nouveau. Le suivi des résultats et les performances associées aux profils facilitent l’analyse post-session, les décisions concernant la composition et le reporting compétitif de base, sans avoir à créer un pipeline de données distinct.

    L’analyse des démos boucle le processus après le scrim

    Construire un cinq ne consiste pas seulement à entrer rapidement sur un serveur. Il faut également tirer profit de chaque session, et QuickFrag répond à ce besoin avec Clip Studio, qui permet aux équipes de téléverser des fichiers de démo de scrim et d’exporter des highlights individuels.

    Ce flux de travail est utile aussi bien pour le coaching que pour la production de contenu. Une équipe peut analyser ses erreurs, identifier des tendances récurrentes et extraire des clips pour une analyse interne sans exporter les données vers une chaîne de montage tierce. L’analyse de la plateforme réalisée par PeerPush souligne également que le traitement des démos prend en charge les clips aux formats 16:9 et 9:16 pour YouTube, TikTok, Instagram Reels, Shorts, Discord et des plateformes similaires.

    Pour un cinq compétitif, il s’agit de bien plus qu’une simple commodité liée aux médias. Lorsque la même plateforme prend en charge les scrims et leur analyse a posteriori, la boucle de feedback se raccourcit et l’équipe peut passer d’une session à la suivante avec moins d’outils et moins de points de défaillance.

    Pourquoi l’architecture de la plateforme compte pour la continuité de l’équipe

    Le positionnement global de QuickFrag consiste à remplacer des outils dispersés. Sa communication destinée aux équipes met directement en avant le problème posé par la gestion simultanée de Discord, des locations de VPS et des tableurs, en demandant si un cinq peut se coordonner sans utiliser cinq applications différentes.

    Cette approche est importante, car la continuité d’un cinq dépend de bien plus que du talent des joueurs. Une équipe a besoin d’un système d’identité stable, d’un moyen fiable de lancer des matchs, d’une méthode pour suivre les résultats et d’un processus d’analyse une fois la partie terminée. QuickFrag centralise ces étapes afin que le cinq ne se dissolve pas dans une surcharge administrative.

    La communication actuelle de la plateforme suggère également que cette orientation produit est activement maintenue. Des références récentes et des horodatages d’exploration indiquent que les profils vérifiés et la mise à disposition instantanée de scrims ne sont pas des fonctionnalités obsolètes enfouies dans une ancienne documentation ; elles font partie du positionnement public actuel destiné aux équipes qui souhaitent gérer des opérations récurrentes en 5v5.

    Pour les équipes e-sport, les ingénieurs de plateforme et les organisateurs de compétitions, la conclusion est simple : QuickFrag est conçu pour rendre le cinq opérationnel, et pas seulement social. En reliant les profils vérifiés, la gestion du roster, les serveurs dédiés instantanés, les scrims privés et l’analyse des démos, la plateforme transforme un groupe de cinq joueurs en une unité d’entraînement plus durable.

    Cette durabilité constitue le véritable gain d’efficacité. Lorsque le cinq peut être constitué, vérifié, lancé, suivi et analysé dans un seul flux de travail, l’équipe passe moins de temps à coordonner l’infrastructure et davantage à améliorer son jeu.

  • Le hub de recrutement de QuickFrag simplifie la recherche de groupes pour les parties classées et l’organisation de scrims privées.

    Le hub de recrutement de QuickFrag simplifie la recherche de groupes pour les parties classées et l’organisation de scrims privées.

    Le workflow d’équipe de QuickFrag repose sur une idée opérationnelle simple : ne plus traiter la gestion de l’effectif, la mise en place des scrims et l’évaluation des joueurs comme des systèmes distincts. Pour les équipes CS2, c’est important, car les moments les plus contraignants sont généralement ceux qui se situent entre « il nous faut cinq joueurs » et « nous disputons un vrai match ». QuickFrag présente son espace de travail comme un hub de recrutement qui aide les équipes à gérer leur effectif, recruter des joueurs et lancer des scrims privés sur des serveurs dédiés, sans les habituels problèmes de coordination.

    Ce choix de conception est particulièrement pertinent pour les académies, les équipes semi-professionnelles et le staff technique qui accompagne la compétition. Au lieu de passer d’échanges Discord à des feuilles de calcul, des locations de VPS et des configurations manuelles de serveurs, les capitaines peuvent centraliser le recrutement et les opérations de match au même endroit. En pratique, une équipe peut publier des essais, examiner les candidatures, discuter avec un joueur avant de l’ajouter à l’effectif, puis faire évoluer le même groupe dans un environnement privé en 5v5 afin de l’évaluer dans des conditions de match.

    Le recrutement et les scrims dans un même workflow

    La page équipe de QuickFrag indique clairement le cas d’utilisation visé : les capitaines peuvent « publier des essais ouverts, examiner les candidatures et discuter avant d’ajouter un joueur à l’effectif ». Cette formulation est importante, car elle relie le recrutement à la mise en pratique. Un candidat n’est pas simplement un profil à examiner ; sur QuickFrag, il peut évoluer dans le même système qui hébergera ensuite les parties privées de l’équipe, ce qui réduit l’écart opérationnel entre l’essai et la validation.

    La plateforme présente également cette approche comme un « hub de scrims et de recrutement » pour les équipes qui doivent agir rapidement. Le fonctionnement recommandé est simple : identifier les candidats, discuter de leur adéquation, puis organiser une semaine de matchs privés si nécessaire. Pour les équipes qui cherchent à évaluer la discipline de rôle, la communication ou la compréhension du jeu, cette continuité est plus précieuse qu’un simple formulaire de candidature ou qu’un serveur d’essai indépendant.

    Du point de vue des opérations d’équipe, le principal avantage est la visibilité. Les données de recrutement ne sont pas stockées dans un outil tandis que les résultats des matchs se trouvent dans un autre. Le modèle de QuickFrag maintient le processus de sélection et celui de validation compétitive dans un même workflow, ce qui permet aux capitaines et aux coachs de prendre plus facilement des décisions fondées à la fois sur les retours humains et sur les résultats en match.

    Des lobbies CS2 privés sans les contraintes de configuration

    Le système de scrims privés de QuickFrag est conçu pour supprimer les contraintes habituelles liées à la configuration des lobbies personnalisés. La plateforme indique que les lobbies CS2 privés utilisent un code d’invitation à six caractères : les équipes n’ont donc pas besoin de partager d’adresses IP ni de coordonner manuellement les informations de connexion. Une fois les dix joueurs prêts, QuickFrag déploie automatiquement un serveur dédié.

    Cette simplicité opérationnelle est importante, car les scrims sont souvent planifiés dans l’urgence. Une équipe peut ne disposer que d’un créneau limité entre le travail, les sessions d’entraînement ou la préparation d’un tournoi, et toute friction lors de la configuration du serveur réduit ce temps disponible. QuickFrag affirme que les scrims privés en 5v5 peuvent être lancés sur des serveurs CS2 dédiés en environ 60 secondes, sans RCON, ce qui rend l’ensemble du processus plus prévisible pour les organisateurs et les coachs.

    En pratique, la couche serveur devient une infrastructure plutôt qu’une tâche à gérer. Les équipes peuvent se concentrer sur le veto des cartes, le test de protocoles ou l’évaluation de nouveaux joueurs, au lieu de résoudre des problèmes de connexion ou de permissions. Pour le staff technique, la différence est comparable à maintenir un environnement plutôt qu’à devoir constamment le surveiller.

    Pourquoi les équipes ont besoin de lobbies accessibles uniquement par code d’invitation

    QuickFrag décrit les matchs privés comme idéaux pour les « stacks », les « soirées en stack » et les « stacks du vendredi soir », et le modèle d’accès reflète ce cas d’utilisation. Seuls les joueurs disposant du code d’invitation peuvent rejoindre la partie, ce qui offre aux équipes un environnement fermé pour s’entraîner, effectuer des tests et répéter leurs exécutions. Dans le jeu compétitif, ce niveau de contrôle n’est pas une simple option pratique ; c’est une condition essentielle à la régularité.

    L’accès uniquement par code d’invitation réduit également les arrivées accidentelles et les problèmes administratifs liés aux lobbies ouverts. Pour une équipe qui cherche à organiser une session propre dans un délai strict, la maîtrise des accès compte autant qu’une faible latence ou que la stabilité du serveur. Elle garantit que la session reste conforme à l’effectif exact que le capitaine souhaite évaluer ou perfectionner.

    La communication de QuickFrag autour des scrims privés gratuits renforce cette accessibilité. La plateforme indique que les équipes peuvent créer un lobby, partager le code d’invitation et jouer en MR15 le soir même. Pour les équipes qui cherchent un moyen pratique de répéter leurs setups, tester le timing de leurs utilitaires ou revoir leur discipline sur les cartes, il s’agit d’un accès simple à de véritables répétitions de match.

    Des serveurs dédiés avec des conditions de match constantes

    QuickFrag souligne que les formats 5v5 privés comme publics fonctionnent sur la même infrastructure de serveurs dédiés. C’est important du point de vue de l’intégrité compétitive, car cela limite les variations d’environnement entre les différents modes de recherche de partie. Les équipes qui évaluent des joueurs en scrim privé travaillent sur la même infrastructure sous-jacente que celle qui alimente les expériences de matchmaking plus larges.

    Pour les organisateurs et les ingénieurs de plateforme, l’intérêt d’une infrastructure partagée réside dans la cohérence. Si l’historique des matchs, les résultats et les données de performance proviennent tous de la même base de serveurs, il devient plus facile d’analyser la stabilité, le comportement des temps de réponse et l’enregistrement des résultats. Les matchs privés de QuickFrag sont accessibles uniquement par code d’invitation, tandis que les matchs publics utilisent une file d’attente ouverte, mais les deux reposent sur la même couche de serveurs dédiés.

    Ce type d’architecture est particulièrement utile lorsqu’une équipe souhaite passer du recrutement à la compétition active sans changer de système. Un joueur peut être testé dans un lobby privé, conservé s’il correspond aux attentes, puis continuer à participer aux sessions suivantes selon les mêmes principes opérationnels. Cette continuité est importante pour les équipes qui accordent de l’importance à la fois à l’adaptation tactique et à la fiabilité de l’infrastructure.

    Suivre les performances, de l’essai à la place dans l’effectif

    QuickFrag indique que l’historique des matchs, les statistiques des joueurs et les résultats sont enregistrés, y compris l’évolution de l’ELO après les scrims. Chaque match privé devient ainsi plus qu’une simple session d’entraînement : il constitue une donnée dans l’évaluation d’un candidat. Pour les coachs et les capitaines, la possibilité d’examiner les performances dans le temps est plus utile qu’une seule partie exceptionnelle ou qu’une impression subjective après le match.

    Le lien avec les profils des joueurs est également utile lorsqu’une équipe teste plusieurs candidats sur une courte période. Comme les résultats sont associés aux profils, les décideurs peuvent comparer la régularité, les performances par rôle et les tendances, plutôt que de se fier à leur mémoire ou à des notes externes. Dans un environnement où les changements d’effectif peuvent coûter cher, disposer d’un historique de performances structuré constitue un avantage pragmatique.

    Pour les équipes disposant d’un staff technique, il existe un avantage supplémentaire : la mesure devient une partie intégrante du workflow au lieu de constituer un projet d’analyse séparé. Il devient ainsi plus facile de mettre en place des cycles d’évaluation rigoureux, de déterminer si l’impact d’un candidat progresse et de documenter les raisons de son ajout à l’effectif. En résumé, la plateforme crée un lien direct entre le recrutement et les résultats compétitifs.

    Remplacer les opérations improvisées par un système d’équipe unique

    QuickFrag présente ouvertement son espace de travail pour équipes comme un moyen de gérer les effectifs, recruter et organiser des tournois « sans jongler entre Discord, les locations de VPS et les feuilles de calcul ». Cela révèle clairement le public ciblé par le produit. Il ne cherche pas à remplacer le jugement des coachs ; il vise plutôt à supprimer la fragmentation des outils qui ralentit les opérations compétitives.

    Pour de nombreuses équipes, le coût caché de ces outils fragmentés réside dans la coordination. Une note sur l’effectif se trouve dans un canal, le calendrier des essais dans un autre, les accès au serveur dans un troisième et le suivi des performances dans une feuille de calcul qui n’est peut-être plus à jour. Le hub de recrutement de QuickFrag simplifie cet ensemble en regroupant les fonctions d’équipe les plus courantes au même endroit, autour d’un modèle opérationnel unique.

    Le résultat est un processus plus facilement traçable. Les capitaines peuvent voir qui a postulé, qui a été discuté, qui a été invité et ce qui s’est passé lors des scrims suivants. Cette clarté est précieuse, que l’équipe soit une académie, un effectif semi-professionnel ou un organisateur gérant plusieurs sessions compétitives avec des contraintes de temps.

    Ce que cela signifie pour les coachs, les organisateurs et les joueurs solos

    Pour les coachs et les organisateurs de compétitions, le modèle de QuickFrag est intéressant, car il raccourcit le parcours entre la découverte, l’évaluation et l’exécution d’un match. Le positionnement « Pour les équipes » de la plateforme est clair : il s’agit d’une plateforme CS2 conçue pour les équipes et les coachs. Il devient ainsi plus facile de mettre en place des cycles de recrutement répétables tout en conservant des scrims privés adaptés aux besoins réels de l’équipe.

    Pour les joueurs solos, le workflow ne se limite pas aux équipes. QuickFrag précise que les joueurs solos peuvent toujours utiliser le recrutement ou le chercheur d’équipe pour trouver un effectif. C’est important, car un bon système de recrutement doit répondre aux deux côtés du marché : les équipes à la recherche de profils et les joueurs à la recherche d’une structure, d’entraînement et d’une chance d’obtenir une place.

    En pratique, la plateforme recommande un modèle opérationnel très précis : utiliser le recrutement pour trouver le bon profil, les scrims privés accessibles par code d’invitation pour le valider, puis la même infrastructure pour faire avancer le processus. Pour les équipes qui accordent de l’importance à la latence, à la régularité et à la préparation tactique, il s’agit d’une manière claire et défendable de gérer les opérations compétitives.

    Le hub de recrutement de QuickFrag n’est pas seulement une fonctionnalité pratique ; c’est une couche opérationnelle dédiée à la gestion moderne des équipes CS2. En réunissant les essais, les scrims privés, les décisions liées à l’effectif et les historiques de matchs, il réduit le nombre d’outils et de transferts manuels nécessaires pour constituer une équipe sérieuse.

    Pour les stacks classées, les académies et les équipes semi-professionnelles, cela signifie un accès plus rapide aux serveurs dédiés, une évaluation plus claire des joueurs et un parcours plus fiable entre l’essai et l’intégration à l’effectif. Dans un environnement compétitif où les petits retards et les configurations irrégulières peuvent nuire à la préparation, disposer d’un workflow unique pour le recrutement et les scrims constitue un avantage concret.

  • Prendre l’avantage en équipe : rotations, signaux et utilitaires inspirés par la méta pro

    Prendre l’avantage en équipe : rotations, signaux et utilitaires inspirés par la méta pro

    Dans la méta pro 2026, l’avantage ne se construit plus seulement à l’aide d’un meilleur aim ou d’un timing d’exécution plus propre. Il se gagne aussi par la qualité des rotations, la lisibilité des signaux utilitaires et la capacité d’une équipe à transformer l’information en déplacement utile. Pour les staffs techniques, les analystes et les organisateurs, cela a un impact direct : la manière dont une escouade lit la carte détermine sa vitesse de décision, sa stabilité en mid-round et sa résistance à la pression.

    Les changements récents confirment cette direction. Riot a clarifié la lecture des utilitaires contrôlables sur la minimap, a renforcé la logique de dialogue entre gunplay et abilities, et a poussé plusieurs cartes vers des rotations plus propres et moins ambiguës. Autrement dit, la méta récompense les équipes capables d’orchestrer des signaux courts, des responsabilités nettes et des transitions rapides entre prise d’espace, repli et reprise d’information.

    1. Ce que la méta 2026 a changé dans la lecture d’équipe

    Le point de départ est simple : Riot a rendu la lecture des utilitaires plus exploitable en match. Depuis Season 2026, les icônes de certaines utilités contrôlables et des drones affichent mieux la direction, la couleur alliée/ennemie et même l’état de poursuite pour certains comportements. En pratique, cela réduit la charge cognitive de l’équipe et améliore la qualité des appels en temps réel, surtout lorsque plusieurs joueurs prennent l’information simultanément.

    Cette clarification n’est pas cosmétique. Elle s’inscrit dans la volonté déclarée de créer un “healthy dialogue” entre les armes et les capacités, avec des moyens clairs de répondre et de s’adapter round après round. Riot a aussi reconnu qu’une utilité mal coordonnée pouvait parfois peser autant qu’une bonne exécution stratégique. Pour une équipe, cela veut dire qu’un bon plan ne suffit pas : il faut un protocole de lecture partagé.

    Dans les faits, les équipes les plus efficaces sont celles qui utilisent la minimap comme une interface de décision, pas comme un simple indicateur passif. Les signaux utilitaires doivent déclencher une hiérarchie d’actions : qui pivote, qui retient l’espace, qui collecte l’info, qui prépare le trade. Plus les rôles sont préassignés, plus la rotation devient automatique et moins elle dépend d’une improvisation coûteuse.

    2. Rotations : réduire le délai entre l’info et le mouvement

    La rotation moderne n’est plus une simple course d’un site à l’autre. C’est une séquence de validation : une information est reçue, recoupée, puis convertie en mouvement. Les modifications de cartes de 2026 vont dans ce sens, avec une réduction de la complexité des angles, des espaces ouverts plus maîtrisés et des temps de rotation défenseur améliorés sur certaines cartes. Cela favorise les équipes qui savent lire le tempo du round sans surréagir.

    Les changements de map pool montrent aussi que cette dynamique reste fluide. Breeze a été entièrement remaniée pour Season 2026, puis retirée plus tard du pool compétitif, ce qui rappelle que les priorités de rotation évoluent vite. Une équipe qui se contente de mémoriser des trajets perd en efficacité dès qu’une modification structurelle change les lignes de visée ou les points de contact.

    Pour les coaches, le bon objectif n’est pas de “faire courir” plus vite l’équipe, mais de réduire le délai entre le premier signal et l’engagement défensif ou offensif. Cela passe par des règles simples : un call principal, un call de confirmation, puis un call d’exécution. Plus la chaîne est courte, plus la rotation devient fiable, même sous pression ou avec des timings incomplets.

    3. Signaux utilitaires : standardiser le langage avant le round

    Les utilitaires les plus forts ne sont pas forcément ceux qui infligent le plus de dégâts. Ce sont souvent ceux qui imposent un langage commun à toute l’équipe. Riot l’a montré avec Tejo, dont les ajustements visaient explicitement à clarifier quand poser certaines salves guidées et comment jouer autour de ses interactions de drone et de reconnaissance. Le message est clair : l’efficacité d’une ability dépend aussi de la qualité du call chain qui l’entoure.

    Cela a des implications directes pour la structure des scrims et des matchs officiels. Si un drone, une smoke ou un projectile exige une interprétation différente selon le joueur qui le lance, l’équipe perd en vitesse et en cohérence. En revanche, si chaque signal est codifié, “scan”, “forcer”, “retard”, “retake”, “reset”, la lecture devient mécanique. On ne discute plus l’intention pendant le round ; on exécute une réponse déjà connue.

    Le patching 2026 va aussi dans cette logique de transparence. Riot a clarifié les états de certains contrôles sur la minimap, justement pour que la prise de décision collective soit plus nette. Dans une optique d’eSports, cela signifie qu’un staff peut construire des playbooks fondés sur des repères observables, reproductibles et auditables, ce qui est essentiel pour le coaching, l’analyse vidéo et la préparation des adversaires.

    4. L’espace, le timing et la valeur des utilitaires agressifs

    Les utilitaires agressifs n’ont pas vocation à être seulement “bruyants”. Ils servent à créer une fenêtre d’avantage, pas simplement à forcer une réaction. Riot l’a formulé très clairement avec Harbor : ses buffs de 2026 visaient à augmenter les fenêtres d’avantage lorsqu’un ennemi est touché par son utilitaire offensif. Cela confirme une orientation forte de la méta : l’utilitaire doit produire un changement de rapport de force mesurable.

    Dans cette logique, le bon usage d’un utilitaire agressif se juge à sa capacité à déclencher un déplacement adverse prévisible. Si l’équipe cible recule, se sépare ou perd son timing de trade, alors le gain d’espace est réel. Si elle reste compacte et conserve sa structure, l’utilité a été gaspillée. Le critère n’est donc pas uniquement le kill, mais la modification du comportement adverse.

    Cette approche est particulièrement importante pour les équipes qui jouent sur le cloud, en scrim international ou sur des infrastructures à latence variable. Moins la décision repose sur l’instantané pur, plus la qualité du plan d’exécution compte. Les utilitaires doivent donc être pensés comme des leviers de tempo, capables d’ouvrir un corridor de mouvement et de sécuriser une transition avant que l’adversaire ne se réorganise.

    5. Cas pro : Yoru, l’information et la rotation globale

    Riot a explicitement identifié Yoru comme un problème de rotation à l’échelle de la carte, en soulignant sa capacité à projeter un avantage map-wide avec une prise d’espace très forte et une flash polyvalente de premier ordre. Cette remarque est essentielle, car elle montre qu’en pro play, la valeur d’un agent ne se limite pas à son impact local. Un outil qui permet de menacer plusieurs zones à la fois perturbe la lecture défensive, même sans contact direct.

    Pour les équipes, cela change la manière de défendre. Il ne suffit plus de couvrir une entrée ou de tenir un angle ; il faut évaluer ce que l’adversaire peut menacer à distance et à quel moment une fake rotation devient crédible. Un Yoru bien utilisé oblige les défenseurs à garder des réserves de réponse : utilitaires de retard, repositionnement minimal, et discipline sur les sur-rotations.

    Le contre-jeu passe donc par la structuration de l’info. Dès que l’équipe comprend qu’un agent peut déplacer la menace sans s’exposer pleinement, elle doit éviter les paniques. Un bon protocole consiste à exiger deux signaux indépendants avant de casser une structure défensive : un indice de présence, puis une confirmation de commit. C’est exactement le type de discipline que la méta actuelle valorise.

    6. Cartes, pool compétitif et adaptation continue

    Le jeu compétitif ne se lit pas seulement à travers les agents, mais aussi via le cycle des cartes. En 2026, Riot a apporté des modifications majeures à une carte pour réduire la complexité des angles, resserrer les espaces ouverts et améliorer les temps de rotation des défenseurs. Breeze a été complètement rework dans 12.00, ce qui rappelle que la macro ne peut jamais être figée si la structure de carte évolue.

    Plus tard, la sortie de Breeze du pool compétitif et l’entrée d’Abyss ont confirmé que la rotation de map pool fait partie intégrante de la préparation. Les équipes qui performent sont celles qui maintiennent une base tactique transférable d’une carte à l’autre : standards de communication, principes de couverture, procédures de retake et gestion de l’économie d’utilitaires. Les détails changent, mais le modèle d’exécution doit rester stable.

    Summit illustre encore mieux cette tendance. Sa structure avec murs droppables qui modifient la carte en plein round oblige à recalibrer les timings, tandis que son mode Retake renforce l’importance des retours coordonnés sous contrainte temporelle. Cette approche montre que Riot pousse le jeu vers des séquences plus lisibles pour les équipes capables d’anticiper les changements, pas seulement pour celles qui “réagissent vite”.

    7. Règles, intégrité et limites de l’avantage utilitaire

    Quand l’utilitaire devient central, les règles doivent aussi évoluer. Les règlements 2026 des Challengers interdisent les abus de textures ou de géométrie qui créent des avantages injustes d’information ou de positionnement, et exigent que l’utilitaire reste destructible et visible comme prévu. Pour les organisateurs et les équipes techniques, c’est un point critique : la méta pro valorise la créativité, mais pas l’exploitation d’un vide de design.

    Il existe toutefois des exceptions très encadrées, comme celle de KAY/O, dont certaines placements hors limites sont explicitement préservés tant qu’ils ne profitent pas d’un exploit de géométrie. Ce type de règle montre bien le niveau de finesse nécessaire dans l’encadrement compétitif. Les staffs doivent connaître les limites exactes pour éviter les erreurs de draft, de setup ou de review réglementaire.

    Au-delà de la conformité, cette rigueur protège aussi la lisibilité du spectacle compétitif. Si les utilitaires deviennent opaques, impossibles à contester ou ambigus dans leurs effets, la qualité des décisions baisse et la méta perd son intérêt tactique. En maintenant une frontière nette entre innovation légitime et abus, Riot favorise un environnement où l’avantage se mérite par la coordination, pas par l’ambiguïté.

    En pratique, prendre l’avantage en équipe en 2026 signifie maîtriser le trio information-rotation-utilitaire. Les ajustements de cartes, les signaux clarifiés sur la minimap et les buffs orientés vers des fenêtres d’avantage montrent une même direction : l’équipe qui gagne est celle qui transforme chaque ability en décision commune, rapide et vérifiable.

    Pour les équipes eSports, les ingénieurs de plateforme et les staffs de compétition, le message est direct : standardisez les calls, réduisez le délai de validation, et concevez vos protocoles comme un système distribué où chaque joueur reçoit, interprète et exécute l’information au bon moment. Dans la méta pro actuelle, l’avantage n’est pas seulement mécanique ; il est organisationnel.

  • Optimiser rotations et placements après la refonte de l’explosion et le retour de Cache

    Optimiser rotations et placements après la refonte de l’explosion et le retour de Cache

    Le retour de Cache en Service Actif a immédiatement rebattu les cartes pour les équipes compétitives. Quand Valve a confirmé, dans la mise à jour du 8 juillet 2026, l’intégration de Cache au groupe Active Duty à la place d’Overpass, la lecture des rotations, des timings et des zones de survie a dû être recalibrée presque du jour au lendemain.

    Ce basculement coïncide avec le lancement de la saison Premier 5 et avec la refonte de l’explosion du C4, deux facteurs qui ont rendu obsolètes plusieurs automatismes accumulés sur les cartes précédentes. Pour les staffs techniques, les analystes et les joueurs, l’enjeu n’est plus seulement de “connaître la carte”, mais de reconstruire des repères fiables autour du mid control, des placements post-plant et des risques liés aux nouvelles zones d’explosion.

    Comprendre le nouveau point de départ compétitif

    Le point le plus important n’est pas Cache elle-même, mais le contexte dans lequel elle revient. La saison Premier 5 démarre en même temps que cette intégration, ce qui signifie une remise à zéro implicite des habitudes : les routes de rotation, les timings d’info et les schémas de reprise de site sont observés dans un environnement où peu d’équipes disposent encore d’un historique stable.

    Cache reste une carte très “skill-forward”, donc particulièrement sensible à l’exécution propre. Dès qu’une carte de ce type change de statut, les équipes qui gagnent rapidement sont celles qui standardisent vite leurs protocoles : qui tient Mid, à quel moment le second joueur se replace, et quel est le seuil de décision pour basculer entre un soutien de site et une rotation plus agressive.

    Dans ce contexte, il faut éviter les lectures trop figées. Les repères issus d’Overpass ou de versions antérieures de Cache ne se traduisent pas mécaniquement, car la refonte Source 2, les correctifs successifs du 9 juillet 2026 puis du 3 août 2026 et les ajustements de géométrie modifient concrètement les chemins, les angles et les trajectoires de vision.

    Le mid control comme colonne vertébrale des rotations CT

    Les analyses récentes de Cache convergent sur un principe simple : le contrôle du centre de la carte dicte la vitesse de rotation vers A ou B. Sur le plan défensif, cela signifie qu’un dispositif CT ne doit pas dépendre de rotations longues depuis un extrême de carte, mais d’un maillage cohérent autour de Mid et Connector.

    Un setup efficace repose généralement sur un anchor par bombsite, un joueur dédié au milieu et un troisième profil prêt à soutenir selon l’information reçue. Cette architecture réduit le temps mort entre une prise d’info et l’arrivée du renfort, ce qui est essentiel sur une carte où un seul duel perdu au centre peut ouvrir une exécution rapide sur l’un ou l’autre site.

    Le rôle de Connector est particulièrement critique, car il sert de point de jonction entre défense statique et réactivité. En pratique, les équipes qui gagnent le plus de rounds sur Cache ne sont pas celles qui tournent le plus tôt, mais celles qui tournent depuis la bonne position, avec assez de couverture pour ne pas abandonner les deux sites trop vite.

    Repenser les placements après la refonte de l’explosion

    La refonte du C4 change la façon dont on évalue les positions “safe”. Valve a précisé que les dégâts sont désormais appliqués via des valeurs de simulation précalculées, intégrées à la carte compilée, avec une propagation depuis le centre de l’explosion. Concrètement, la lecture du danger devient plus structurée, moins instantanée et plus dépendante de la géométrie réelle.

    Le résultat tactique est immédiat : les placements à la lisière de la blast zone sont plus précis qu’avant, mais aussi plus exigeants à apprendre. L’onde de choc se dissipe dans les coins et ne traverse pas les murs, ce qui introduit des écarts nets entre une position théoriquement proche du danger et une position réellement exposée.

    Pour les équipes, cela impose une cartographie nouvelle des post-plants et des ancrages défensifs. Certains spots jadis considérés comme “juste assez sûrs” doivent être revalidés à la frame près, surtout dans les zones où la couverture géométrique crée un faux sentiment de sécurité.

    Adapter les post-plants et les ancrages sur Cache

    Sur Cache, la nouvelle explosion influence directement la qualité des survivants post-plant. Comme les dégâts se propagent depuis le centre et perdent de l’intensité dans les angles, la composition d’un duo post-plant ne doit plus seulement viser la ligne de vue idéale, mais aussi la robustesse de la position face à la blast zone et aux murs adjacents.

    Cela affecte particulièrement les scénarios où un joueur se cache derrière une couverture partielle ou dans une niche censée “manger” une partie de l’explosion. Les nouveaux calculs rendent certains refuges plus fiables, tandis que d’autres deviennent des illusions de sécurité. Sur Cache, où les timings de reprise sont déjà rapides, cette différence peut décider d’un round entier.

    Les ancrages défensifs doivent suivre la même logique. Un joueur qui tient un angle d’arrêt doit connaître non seulement sa ligne de visée, mais aussi le coût d’un repositionnement au moment du plant. Si la bombe est posée et qu’un retake est probable, la position de départ doit permettre une sortie cohérente sans dépendre d’un timing “chanceux” face au rayon d’explosion.

    Exploiter la géométrie mise à jour sans surjouer les angles

    Les correctifs de juillet puis d’août 2026 ont surtout confirmé que Cache n’était pas simplement “de retour”, mais encore en stabilisation. Les changements de géométrie, de collision et de visibilité ont un impact direct sur les crosshairs, les pré-aims et les lignes de défense, notamment autour de A, de Checkers et de B Main.

    La conséquence pratique est simple : il faut réapprendre les angles à partir du terrain actuel, pas de la mémoire historique. Une bordure de mur modifiée, un objet déplacé ou une ligne de vue légèrement corrigée peuvent transformer un duel 60/40 en exposition inutile. Dans ce type de carte, les équipes les plus performantes sont souvent celles qui traitent la géométrie comme une donnée de production, pas comme un décor.

    Pour les staffs, cela veut dire documenter les spots de tenue avec des captures à jour, des repères de visée stables et des annotations précises sur les risques d’overpeek. Plus la carte reste en reconstruction, plus la discipline de calibration devient un avantage compétitif.

    Optimiser les rotations T autour des fenêtres d’information

    Côté attaque, Cache récompense les rotations rapides mais propres. L’objectif n’est pas de traverser la carte sans plan, mais d’exploiter les fenêtres d’information pour forcer les CT à dévoiler leur dispositif. Une prise de mid bien orchestrée oblige souvent la défense à révéler son point faible, ce qui ouvre ensuite une rotation d’attaque vers le site le moins densément couvert.

    La priorité doit donc être donnée aux séquences où l’équipe peut confirmer la présence ou l’absence de contrôle CT avant de déclencher le reste du round. Sur Cache, envoyer des joueurs trop tôt sans lecture conduit à se heurter à des setups de reprise très solides, tandis qu’une rotation attaquante basée sur un timing clair permet de punir les repositionnements défensifs tardifs.

    Le rythme idéal combine pression, information et conservation des utilitaires. Une équipe qui sait maintenir la menace au centre tout en gardant ses options ouvertes force les CT à choisir entre deux mauvais choix : rester compact et céder l’espace, ou bouger trop tôt et fragiliser la structure de défense.

    Gérer les armes lâchées et les fins de round

    Un détail souvent négligé dans les lectures stratégiques concerne les armes lâchées. L’update du 8 juillet 2026 précise que la nouvelle explosion du C4 exerce davantage de force sur les armes au sol, ce qui peut changer la manière dont on sécurise un duel de fin de round ou une récupération après un plant contesté.

    Dans un environnement compétitif, ce paramètre n’est pas anodin. Une arme déplacée par l’explosion peut sortir d’une zone de récupération prévue, casser un plan de reprise ou forcer un joueur à s’exposer davantage pour la récupérer. Sur Cache, où les fins de round sont souvent très dépendantes des micro-positions, cela mérite d’être intégré aux protocoles de fin de manche.

    Les équipes devraient formaliser des règles simples : quelles armes doivent être sécurisées en priorité, qui couvre la récupération, et dans quelle mesure le risque de déplacement par explosion modifie le comportement autour du C4. Ce genre de détail, invisible sur un scoreboard, peut pourtant faire basculer plusieurs rounds d’une série.

    Construire une méta de Cache durable

    Depuis août 2026, les guides de méta insistent sur le fait que Cache reste en reconstruction stratégique. Les communautés parlent encore d’une carte en optimisation, avec des repères de rotations, de timings et de post-plants qui s’affinent à mesure que les équipes rejouent la carte à haut niveau. Cela signifie qu’aucun playbook ne doit être considéré comme définitif.

    La bonne approche consiste à industrialiser l’adaptation. Les équipes qui montent vite en puissance sur Cache sont celles qui enregistrent leurs scrims, comparent les timings, documentent les nouvelles fenêtres de reprise et testent les placements sous différentes conditions d’explosion. En d’autres termes, il faut traiter la carte comme un système à versionner, pas comme une routine fixe.

    Pour les organisateurs et les éditeurs de contenu, cette période est aussi une opportunité : le retour de Cache a créé un besoin immédiat de guides clairs, de repères visuels et d’analyses actualisées. Plus les sources officielles de Valve sur Counter-Strike.net sont croisées avec des retours de terrain précis, plus la lecture tactique gagne en fiabilité.

    Au final, optimiser rotations et placements sur Cache après la refonte de l’explosion revient à accepter une nouvelle discipline de lecture. Les équipes qui progresseront le plus vite seront celles qui contrôlent Mid proprement, réévaluent leurs spots à la lumière de la nouvelle blast zone et structurent leurs rotations autour d’informations vérifiées, pas d’habitudes héritées.

    Cache redevient une carte d’exécution, de timing et de détail. Dans cette phase de transition, l’avantage compétitif appartient à ceux qui savent transformer chaque patch en méthode de travail, puis chaque méthode de travail en rounds plus stables.

  • Exploiter les nouveaux hooks de script pour créer des drills de fumigènes ultra-précis

    Exploiter les nouveaux hooks de script pour créer des drills de fumigènes ultra-précis

    Dans l’écosystème Source 2 et CS2, l’idée de « nouveaux hooks de script » pour industrialiser l’entraînement aux fumigènes revient souvent dans les discussions d’équipes et d’ingénierie. Pourtant, côté sources publiques récentes, on ne trouve pas de documentation fiable et explicitement dédiée à des hooks « nouveaux » orientés drills de fumigènes ultra-précis : les références accessibles pointent surtout vers des concepts généraux (scripts d’armes, entités, console/outillage, paramètres de lancement).

    Cet article adopte donc une approche pragmatique : partir de ce qui est techniquement établi (grenades en tant qu’entités, scripts/console/outils Source 2) pour bâtir une méthode de drills reproductibles, mesurables, et compatibles avec les contraintes eSports (latence, tickrate, variance réseau, standardisation des postes). L’objectif est de fournir un cadre d’implémentation pour vos contenus internes QuickFrag, vos serveurs d’entraînement, et vos procédures d’édition/tactique.

    1) Clarifier ce que l’on peut (et ne peut pas) appeler « hooks » en pratique

    Dans un contexte d’entraînement, un « hook » n’est pas forcément une API flambant neuve documentée noir sur blanc : c’est souvent un point d’injection opérationnel dans le cycle de jeu. En Source 2, les voies réalistes ressemblent davantage à des enchaînements outillés : commandes console, configs, paramètres de lancement, scripts côté serveur, et instrumentation via entités/logic de carte.

    Les sources ouvertes disponibles rappellent surtout deux faits utiles : (1) les projectiles/grenades sont traités comme des entités à part entière, et (2) une grande partie des comportements d’armes peut être décrite par des scripts (au sens large des définitions/paramétrages). Même si cela ne constitue pas une « nouveauté » orientée drills, c’est un socle suffisant pour construire des routines ultra-consistantes.

    Il faut également cadrer les attentes de votre staff : sans hooks explicitement documentés pour « capturer la trajectoire d’un fumigène » ou « valider une lineup » dans CS2, la précision viendra d’un pipeline d’exécution contrôlé (mêmes variables d’entrée, même scène, même timing), puis d’une vérification par observation/instrumentation (positions, zones, temps, états d’entités) plutôt que d’un évènement script magique.

    2) Penser « fumigène » comme entité instrumentable, pas comme simple animation

    Pour concevoir des drills, considérez le fumigène comme un objet de simulation : il existe, se déplace, interagit avec la géométrie, puis déclenche un état (déploiement de la fumée) dans un espace/temps. Le point clé confirmé par la documentation Valve côté concepts Source est que les projectiles/grenades sont des entités : cela ouvre la voie à des scénarios où l’on observe ou contraint ces entités.

    Dans la pratique, cela signifie que vos cartes d’entraînement (ou vos variantes internes) peuvent intégrer des repères et des volumes de validation : zones cibles, volumes d’erreur acceptables, déclencheurs de reset, et panneaux d’état. Même sans « hook » d’API, les entités logiques d’une map peuvent vous servir de bus d’évènements : entrée dans un volume, collision, temporisation, reset de round, etc.

    Pour une précision « ultra » (au sens eSports), l’instrumentation doit être répétable et lisible par des non-développeurs (coach, analyst, editor). Un bon compromis consiste à traduire le résultat attendu en critères simples : « le centre du nuage doit couvrir tel choke », « la ligne de vision A↔B doit être coupée entre t=2,0s et t=19,0s », « aucune fuite sur tel angle ». Ce sont des métriques observables, donc automatisables partiellement via logique de map et protocoles de test.

    3) Standardiser l’exécution via console, configs et paramètres de lancement

    En absence de documentation publique récente sur des hooks spécifiques à des drills de fumigènes ultra-précis, la voie la plus robuste est l’automatisation par l’environnement : paramètres de lancement Source 2, configs server/client, et scripts de démarrage (exec). Ces mécanismes sont une constante dans la famille Source et restent pertinents pour imposer un cadre identique à chaque session.

    Concrètement, l’objectif est de figer tout ce qui crée de la variance : timeouts, cadence de reset, état économique, équipement, position initiale, et rythme de reprise. Un protocole type : (1) chargement de la map d’entraînement, (2) exécution d’un fichier de config « drill_smoke.cfg », (3) téléport/placement du joueur, (4) dotation en grenades, (5) lancement d’une boucle de répétition avec reset rapide.

    Côté infrastructure, les équipes plateforme gagnent à pousser ces configs au plus près du serveur d’entraînement (images/containers, gestion de versions, rollbacks). Vous réduisez ainsi les « dérives de poste » (un PC avec un bind manquant, une config différente, un alias absent) et vous garantissez que l’éditeur vidéo ou le coach reproduit exactement la même séquence qu’un joueur, avec une empreinte de configuration vérifiable.

    4) Construire des drills déterministes : entrées contrôlées, sorties vérifiables

    Un drill « ultra-précis » n’est pas seulement une lineup difficile : c’est un test déterministe. Pour y arriver, vous devez verrouiller les entrées : position du joueur (coordonnées et orientation), mouvement (immobile / pas précis), timing (top départ), et action (type de lancer). Même si vous ne disposez pas d’un hook dédié, vous pouvez simuler ce déterminisme via placements fixes, repères visuels et séquences standardisées.

    La sortie doit ensuite être vérifiable. Deux approches complémentaires fonctionnent bien en environnement eSports : (1) validation « géométrique » par zones (la fumée doit impacter/couvrir un volume), et (2) validation « tactique » par ligne de vue (un angle doit être bloqué). La première est plus facile à automatiser dans une map outillée, la seconde est plus proche de la réalité scrim mais demande une mise en scène (bots, caméras, checks).

    Enfin, prévoyez un système de notation simple pour le joueur : succès/échec, proche/loin, et un message d’instruction (correction de visée, timing, hauteur). Un drill sans boucle de feedback immédiat devient un simple exercice répétitif. Même minimaliste, un feedback cohérent accélère la convergence vers une exécution stable.

    5) Intégrer la latence et la variabilité serveur dans l’entraînement (sans se mentir)

    QuickFrag couvre l’infrastructure et la latence pour une raison : un drill utile doit survivre au contexte match. Un fumigène « parfait » en local peut se dégrader si vos conditions d’entraînement n’imitent pas les conditions serveur (netcode, cadence, charge). Sans chiffres publics récents et fiables spécifiquement sur l’impact en CS2 pour ces drills, la bonne pratique reste de tester dans des environnements représentatifs.

    Au minimum, maintenez deux profils d’exécution : un mode « lab » (local/serveur interne, reset ultra-rapide, visée/inputs) et un mode « match-like » (serveur dédié, slots, charge réaliste, règles proches compétition). L’objectif n’est pas de rendre le drill plus difficile artificiellement, mais de s’assurer que le résultat tactique (blocage d’angle, timing d’exécution) ne dépend pas d’un contexte non reproductible.

    Côté ops, surveillez les variables qui ruinent la comparabilité : instabilité de performance serveur, contention CPU, migrations de VM, jitter réseau sur le site d’entraînement. La discipline « SRE » appliquée au training (observabilité, changements contrôlés, versioning) fait gagner du temps au staff tactique et réduit les disputes « ça marche chez moi ».

    6) Industrialiser : versionner les drills, documenter, et produire du contenu réutilisable

    Une fois le mécanisme en place (map outillée + configs + protocole), le vrai gain vient de l’industrialisation. Traitez chaque drill comme un artefact versionné : nom, objectif tactique, prérequis (side, utilitaire), étapes, critères de réussite, et variantes. Sans cela, votre base de drills devient vite une collection de « trucs » non maintenables.

    Pour les éditeurs et analystes, fournissez des sorties standard : un identifiant de drill, un mini-script de lancement, un angle caméra recommandé, et un format de note. Même si vous ne pouvez pas extraire automatiquement toutes les métriques (faute de hooks publics dédiés), vous pouvez standardiser la capture (démarrage, reset, répétitions) et rendre les comparaisons fiables entre joueurs, rosters et périodes.

    Enfin, gardez une séparation claire entre « expérimental » et « compétition ». Les mécaniques non documentées ou les techniques trop dépendantes d’un état particulier du jeu risquent de casser après patch. En l’absence de sources fiables décrivant des hooks nouveaux et stables, votre gouvernance interne doit privilégier la robustesse : drills simples, reproductibles, et faciles à revalider après mise à jour.

    Sans documentation publique récente pointant explicitement vers de « nouveaux hooks de script » dédiés aux fumigènes en CS2, l’approche la plus sûre consiste à exploiter les points d’ancrage réellement établis dans l’écosystème Source : entités (grenades/projectiles), logique de map, console/outillage, et paramètres de lancement. Ce n’est pas moins puissant : c’est simplement plus méthodique, et souvent plus durable.

    En traitant chaque fumigène comme un scénario déterministe (entrées contrôlées, sorties vérifiables), en standardisant l’environnement d’exécution (serveur, configs, versioning) et en intégrant les contraintes d’infrastructure (latence, jitter, charge), vous obtenez des drills de fumigènes ultra-précis au sens compétitif du terme : reproductibles, auditables, et directement exploitables par le staff tactique comme par l’ingénierie.

  • Après Cologne : le retard du classement Valve déclenche un remaniement des équipes

    Après Cologne : le retard du classement Valve déclenche un remaniement des équipes

    Dans l’écosystème CS où le Valve Regional Standings (VRS) conditionne désormais les invitations, la moindre friction de calendrier devient un incident opérationnel. Après Cologne, ce n’est pas un clutch raté qui a fait basculer les plans, mais un décalage de publication : la sortie de septembre a été publiée le 9 septembre 2026, soit un jour plus tard que la routine du « premier lundi », déclenchant une zone grise pour les organisateurs.

    Ce retard, puis une « antidatation » de la publication au 7 septembre, a exposé une vérité que les équipes, les TO et les ingénieurs plateforme connaissent bien : la compétition moderne est autant un problème de données, de timing et d’infrastructure que de niveau de jeu. Les conséquences se lisent dans les invitations, les têtes de série… et, indirectement, dans les décisions de remaniement des équipes, prises au plus près des fenêtres VRS.

    1) Le VRS comme source de vérité… jusqu’au moment où il arrive en retard

    Selon HLTV, Valve a publié le VRS de septembre le 9 septembre 2026, alors que de nombreux acteurs s’attendaient au premier lundi du mois. Cette journée de décalage a suffi à créer une divergence de références : certains organisateurs avaient déjà planifié invitations et seeding sur la base du classement du mois précédent, faute de mise à jour disponible.

    HLTV décrit explicitement que ce retard a « caused some chaos among tournament organizers », notamment parce que des dates d’invitation et de répartition des têtes de série avaient été alignées sur le 7 septembre 2026. Dans un cadre où chaque point VRS peut déplacer une équipe d’un rang, c’est l’équivalent d’un déploiement de configuration critique effectué avec un artefact obsolète.

    Le contexte explique en partie l’anomalie : le premier lundi de septembre 2026 tombait sur le Labor Day aux États-Unis, élément cité par HLTV comme facteur probable du décalage. Mais côté opérations, la cause importe moins que l’impact : un SLA implicite a été rompu, et la chaîne d’outillage des TO (planning, invitations, seeding, communication) s’est retrouvée en mode « incident ».

    2) Antidater la publication ne corrige pas la donnée : l’effet dataset

    Après la publication tardive, Valve a ensuite antidaté le VRS au 7 septembre 2026 pour résoudre un problème spécifique, d’après HLTV. Toutefois, la donnée utilisée semblait provenir du 8 septembre 2026, ce qui a modifié l’ensemble d’événements pris en compte dans le calcul.

    Techniquement, c’est un cas classique de « timestamp mismatch » : l’étiquette (date de publication) indique une version, mais le contenu (dataset) correspond à une autre. Pour les organisateurs, cela complique l’auditabilité : quelle version était « la plus récente » au moment exact où les invitations ont été gelées ? Pour les équipes, cela introduit une volatilité non liée à la performance en serveur mais à la frontière temporelle du calcul.

    HLTV donne un exemple concret : l’ESL Challenger S52 Europe Cup 6, événement non terminé à ce moment, aurait été inclus dans le dataset du 8 septembre mais n’aurait pas été inclus dans un dataset au 7 septembre. Ce type d’inclusion « à la limite » suffit à décaler des points, donc des rangs, donc des trajectoires d’invitation.

    3) TOR, conformité et seeding : quand la règle dépend d’un horodatage

    HLTV cite les Tournament Operation Requirements (TOR) comme le cadre directement impacté. La section 3.2.3 impose aux TO d’utiliser la version la plus récente du VRS « as of the Invite Date ». La section 4.3 exige en plus que la date de publication du VRS soit explicitement mentionnée pour le seeding.

    En pratique, un retard de publication transforme ces exigences en casse-tête de conformité : si l’Invite Date est le 7 septembre et que le VRS n’existe officiellement (publié) que le 9, les TO sont forcés de se baser sur l’ancien classement, puis de justifier pourquoi ils n’ont pas utilisé une version qui n’était pas encore disponible. L’antidatation ajoute une couche : la date affichée peut ne pas refléter la date de calcul.

    Pour les plateformes et équipes ops, la leçon est nette : le VRS n’est pas seulement un classement, c’est un artefact réglementaire. Il doit être versionné, horodaté et traçable comme une release logicielle. Sans cela, les TO se retrouvent à gérer des litiges potentiels, et les équipes à naviguer une incertitude qui affecte directement leur roadmap compétitive.

    4) Cologne, invites et effet de cutoff : la sensibilité extrême aux dates

    HLTV rappelle, via la couverture Cologne Major, que le VRS décide désormais toutes les équipes participantes : les qualifications ont été progressivement éliminées au profit d’un système d’invitations basé sur le ranking. Cette centralisation augmente mécaniquement la sensibilité aux cutoffs et aux retards.

    L’exemple de Cologne est parlant : la page d’invitation mentionne des invites basées sur un classement officiel Valve daté du 6 avril 2026. Ce simple point de calendrier a déterminé qui entrait dans le Major et à quel stade. Quand un système devient « data-driven », la gouvernance de la donnée (calendrier, disponibilité, cohérence) devient une composante de l’équité sportive.

    Et l’enjeu est encore plus fort en Europe : HLTV indique que la région a obtenu 17 des 32 places du Major, réparties entre les Stages 1, 2 et 3. Une fluctuation marginale autour d’une fenêtre VRS européenne peut donc avoir un impact disproportionné sur le parcours (et le revenu) d’une organisation.

    5) Haut du classement stable, points mouvants : pourquoi l’écart compte

    Au sommet, le VRS mondial de septembre (dataset du 8 septembre selon HLTV) affiche Spirit en tête avec 2031 points, devant MOUZ (1902) et Falcons (1881). Cette stabilité apparente masque pourtant une réalité : les points évoluent, et l’ordre régional peut se jouer sur des différences faibles au moment exact où un TO fige ses listes.

    HLTV montre aussi que sur le VRS Europe, le haut du classement reste stable entre le 11 et le 14 septembre, avec Spirit toujours premier (2035 puis 2037 points), MOUZ deuxième et Falcons troisième. Mais le déplacement des points prouve que le système « bouge » même quand les positions ne changent pas, ce qui devient critique dès qu’on regarde les équipes au voisinage des seuils d’invitation.

    Pour les staffs techniques, c’est l’équivalent d’une latence qui ne fait pas tomber le service, mais change le comportement à la marge : les mêmes équipes restent en haut, mais la distribution de points autour des cutlines peut pousser une organisation à accélérer une décision de roster, ou au contraire à geler toute prise de risque.

    6) Pourquoi un retard VRS se traduit en remaniement des équipes

    Le lien entre retard de classement et remaniement peut sembler indirect, mais il est pragmatique : les équipes optimisent pour des fenêtres d’invitation. Si la date de référence est incertaine, une organisation hésite entre maintenir une line-up (stabilité, synergie) ou changer (gain de niveau), sans savoir quel « snapshot » VRS sera utilisé par les TO.

    Après Cologne, HLTV notait que la « rostermania » attendue ne s’est pas pleinement matérialisée, beaucoup d’organisations optant pour le belt-tightening plutôt que des dépenses agressives. Cette prudence est aussi liée à l’adaptation au nouveau système de stickers introduit par Valve avant l’IEM Cologne Major : les projections de revenus changent, et donc la tolérance au risque de remaniement aussi.

    Pourtant, le marché n’est pas resté immobile : les archives transferts HLTV montrent des mouvements récents, comme NIP recrutant adamb, The MongolZ mettant DarkMeister sur le banc, ou paiN remplaçant piriajr par Tatu. Ces ajustements « de bord » deviennent plus fréquents quand les équipes cherchent des gains ciblés (rôles, firepower, map pool) sans déclencher un coût d’intégration trop élevé au mauvais moment du cycle VRS.

    7) Implications infra : latence, planification et discipline de release

    Du point de vue QuickFrag (hosting, infra, latence), l’épisode met en évidence une discipline de release qui devrait ressembler à celle d’un produit cloud : calendrier publié, fenêtre de maintenance, artefact immuable, et historique consultable. Quand un classement est l’entrée de processus réglementés (TOR) et commerciaux (invites), une publication « best effort » est structurellement insuffisante.

    Pour les TO, la mitigation passe par des runbooks : définir une « Invite Date » qui intègre une marge, documenter la version VRS utilisée, archiver les preuves (capture de page, hash de document si disponible), et prévoir un plan de re-seeding si une version est publiée tardivement. Ce sont des pratiques de SRE appliquées à la compétition.

    Pour les équipes, la mitigation est un mix de performance et de gouvernance : monitorer l’évolution VRS, identifier les événements susceptibles d’entrer/sortir d’un dataset à la frontière (comme l’ESL Challenger S52 Europe Cup 6 mentionné par HLTV), et éviter les changements de roster majeurs à proximité des fenêtres où l’incertitude de publication peut amplifier l’impact d’un léger mouvement de points.

    Après Cologne, le retard du classement Valve n’a pas seulement perturbé des tableaux de seeding : il a révélé une dépendance systémique à un calendrier de données. Entre publication le 9 septembre, antidatation au 7 et dataset semblant venir du 8, l’incident a mis sous tension TOR, invitations et crédibilité opérationnelle.

    Dans un circuit où le VRS décide de tout, jusqu’à la répartition des 17 places européennes sur 32 au Major, la conclusion est pragmatique : la stabilité compétitive ne dépend plus uniquement des scrims et du serveur, mais aussi de la robustesse des releases. Tant que cette couche restera vulnérable aux retards et aux ambiguïtés d’horodatage, les équipes continueront d’ajuster leurs effectifs au rythme des fenêtres VRS, parfois plus par gestion du risque que par stratégie purement sportive.

  • Le passage aux moniteurs 500 Hz : quel impact sur les configurations des joueurs du shooter de Valve

    Le passage aux moniteurs 500 Hz : quel impact sur les configurations des joueurs du shooter de Valve

    Le passage aux moniteurs 500 Hz n’est plus un sujet de laboratoire : il s’inscrit désormais dans la trajectoire naturelle des setups esports autour du shooter de Valve (Counter-Strike 2). Le fait que le PGL CS2 Major Singapore 2026 soit annoncé comme le premier Major joué sur écran OLED, avec un modèle 24,5 pouces officiel (ASUS ROG Swift OLED PG259QWS Ace), confirme que l’industrie investit dans des écrans pensés pour l’ultra-basse latence et la lisibilité en mouvement.

    Pour les équipes, ingénieurs plateforme et organisateurs, la question n’est pas “500 Hz est-ce utile ?” mais “qu’est-ce que cela implique sur toute la chaîne : FPS, frametimes, pipeline d’entrée, profils d’affichage, et standardisation événementielle”. À ce niveau, un écran plus rapide devient un amplificateur : il expose immédiatement les instabilités de performance et les incohérences de configuration.

    1) 500 Hz : un palier déjà exploitable, pas une promesse marketing

    Le 500 Hz est un jalon concret sur le marché esports. ASUS documente des modes 1920×1080 @ 500 Hz sur certains écrans, ce qui signifie que la fréquence n’est pas seulement “annoncée” : elle est utilisable via des timings et des modes validés, avec des contraintes connues (câblage, DSC éventuel, paramètres GPU/OS).

    Dans un shooter tactique comme CS2, l’intérêt n’est pas de “voir 500 images” de manière abstraite, mais de réduire la latence d’affichage et d’augmenter la granularité temporelle. À 500 Hz, la fenêtre entre deux rafraîchissements tombe à 2 ms, ce qui diminue le délai maximal d’attente avant qu’une image prête ne soit affichée.

    Il faut toutefois cadrer l’attente : passer de 240/360 Hz à 500 Hz n’est pas un saut perceptif identique à 60→144 Hz. Le gain se manifeste surtout dans les micro-ajustements (tracking, correction de flick), et dans la cohérence “input-to-photon” quand le reste du système est optimisé.

    2) L’écran 500 Hz impose une discipline FPS/frametimes

    L’impact principal du 500 Hz sur les configurations des joueurs est la nécessité de maintenir des FPS très élevés et stables. Sans un framerate suffisamment haut, l’écran n’est pas “alimenté” : on perd l’intérêt de la fréquence, et on retombe sur un comportement dominé par les variations de frametime (micro-saccades, sensation de lourdeur).

    Dans la pratique compétitive, HLTV rappelle constamment,via les réglages vidéo partagés par les pros depuis la sortie de CS2,que la performance et le ressenti priment. Cela se traduit par des réglages “low-latency”, une charge GPU contenue et une recherche de constance plutôt que de qualité visuelle.

    Pour une organisation, cela implique d’évaluer les configs non pas à “FPS moyen”, mais à la distribution des frametimes (p99/p99.9). Un 500 Hz valorise un pipeline stable : fréquence CPU, scheduling, limites de puissance, et absence de spikes (télémetry, overlays, tâches de fond) deviennent des points d’audit obligatoires.

    3) 1080p, 24,5 pouces, et 4:3 : continuité des standards compétitifs

    Les joueurs n’augmentent pas forcément la résolution parce que les moniteurs accélèrent. HLTV rappelle que la majorité des pros CS historiques privilégient encore du 24”/1080p, souvent même en 4:3, ce qui indique que la lecture, la mémoire musculaire et la performance passent avant la définition.

    Le choix d’un moniteur officiel de Major en 24,5 pouces, “based on feedback from pro players”, renforce cette continuité. L’arrivée de l’OLED et des refresh rates extrêmes ne remet pas en cause le format dominant : elle le “durcit” comme standard, car il optimise à la fois la densité de pixels perçue et la charge à rendre pour atteindre des FPS élevés.

    Pour les équipes et les organisateurs, c’est une bonne nouvelle opérationnelle : la transition vers 500 Hz ne nécessite pas de requalifier tout le parc d’affichage vers 1440p/4K. Le principal chantier est l’homogénéité (mêmes tailles, mêmes modes, mêmes profils), plus que l’augmentation de résolution.

    4) Chaîne d’entrée : souris, polling rate, OS et cohérence temporelle

    À mesure que la fréquence d’affichage monte, le débat se déplace vers la cohérence globale du setup. Les guides et profils discutés dans l’écosystème HLTV mentionnent souvent le polling rate souris, les réglages Windows, les options de lancement et les paramètres in-game, parce que chaque composant peut introduire de la gigue.

    Un moniteur 500 Hz rend plus visibles les “désalignements” : une souris à haut polling rate n’apporte pas de bénéfice si le système est instable (DPC latency, USB power saving, priorités, interruptions). De même, des paramètres d’OS qui provoquent des spikes (services, overlays, capture) peuvent dégrader la sensation même si le compteur FPS reste élevé.

    En environnement compétitif ou événementiel, l’enjeu est de documenter une baseline reproductible : mêmes politiques d’alimentation, même configuration USB, mêmes versions de pilotes, mêmes restrictions d’overlay. Le 500 Hz n’est pas un composant isolé ; c’est un point de convergence qui pousse à l’ingénierie de timing.

    5) OLED, outils “pro esports” et standardisation par profils

    Le PGL CS2 Major Singapore 2026 annoncé comme premier Major sur OLED illustre une deuxième tendance : la montée des refresh rates s’accompagne d’une normalisation des outils “pro esports”. ASUS associe ses écrans ultra-rapides à des modes couleur esports, des menus rapides, des capteurs/repères de position et des protections OLED, ce qui vise à réduire la variance entre postes.

    Un point clé pour les opérations : les fabricants intègrent des fonctions de partage de profils d’affichage. ASUS met en avant “Pro Setting to Share” pour exporter/importer/partager les réglages du moniteur. En pratique, cela transforme l’écran en élément de configuration versionnable, à côté des configs jeu et des profils driver.

    Pour un organisateur ou un staff technique, cela ouvre une approche plus industrielle : définir un profil événement (couleur, overdrive, luminosité, protections OLED, mode low-latency), le valider, puis le déployer sur tout le parc. Cela réduit les ajustements manuels, raccourcit les checks pré-match, et diminue les litiges liés aux “différences de ressenti” entre stations.

    6) Implications infrastructure/serveur : le 500 Hz ne compense pas la latence réseau

    Dans une perspective QuickFrag (hosting, serveurs, latence), il est crucial de rappeler que 500 Hz agit sur la partie locale (entrée → rendu → affichage). Il ne “répare” pas une mauvaise route réseau, une congestion, un jitter élevé ou un tickrate/processing serveur défavorable.

    En revanche, un affichage plus rapide peut amplifier la sensibilité des joueurs aux irrégularités réseau : quand le client est extrêmement fluide, les variations de délai (jitter) et les anomalies de synchronisation (rubber-banding, retards d’enregistrement ressentis) deviennent plus saillantes. Autrement dit, on réduit le bruit côté client, et le réseau/serveur devient plus “auditable” par l’expérience joueur.

    Pour les équipes et les plateformes, cela plaide pour des budgets de latence end-to-end plus stricts : peering, localisation serveur, contrôle de bufferbloat, monitoring temps réel (RTT, jitter, loss) et cohérence des routes. Le 500 Hz est un investissement local ; pour en récolter la valeur compétitive, l’infrastructure doit rester au même niveau d’exigence.

    Le passage aux moniteurs 500 Hz dans l’écosystème CS2 est donc moins une révolution visuelle qu’une montée en exigences d’ingénierie : il faut des FPS très élevés et, surtout, des frametimes stables. Les indices récents,Major sur OLED, formats 24,5 pouces conservés, modes 1080p @ 500 Hz documentés,montrent que la scène compétitive Valve continue d’orienter le marché vers la performance mesurable et reproductible.

    Pour les structures esports, staffs IT et organisateurs, la priorité est la cohérence : profils d’écran partageables, baseline OS/pilotes, réglages “low-latency” et contrôle de la chaîne d’entrée, sans oublier l’infrastructure réseau. À 500 Hz, chaque milliseconde gagnée côté poste met en lumière celles qui restent ailleurs,et c’est précisément ce qui en fait un levier pragmatique pour professionnaliser les configurations.