Blog

  • Le retard des VRS pousse les organisateurs à revoir leurs plannings

    Le retard des VRS pousse les organisateurs à revoir leurs plannings

    Dans l’organisation d’un événement eSport, un “retard des VRS” peut vite devenir un raccourci pratique pour désigner un blocage critique côté infrastructure: validation d’un stack serveur, mise à disposition d’un environnement de compétition, ou encore stabilisation d’une fonctionnalité de spectating/anti-triche. Le problème, c’est que le sigle VRS est ambigu et qu’aucune actualité récente et fiable ne relie explicitement un “retard des VRS” à une révision de plannings d’organisateurs.

    Chez QuickFrag, on préfère donc traiter le sujet comme un cas opérationnel: quand un composant clé de l’écosystème “serveurs” prend du retard (qu’il s’agisse d’un prestataire, d’un outil, d’une validation réglementaire ou d’une contrainte terrain), les organisateurs doivent ajuster le calendrier. Et ces ajustements se font rarement “à l’intuition”: ils se décident en fonction de jalons techniques, de dépendances administratives et de risques (latence, capacity planning, stabilité, conformité).

    1) VRS: un sigle flou, un risque concret de mal cadrer le problème

    Les recherches disponibles ne permettent pas d’identifier une source récente et solide confirmant une actualité intitulée “Le retard des VRS pousse les organisateurs à revoir leurs plannings”. En pratique, cela signifie qu’un organisateur ou un éditeur de contenu peut se retrouver à commenter un “retard” sans en définir le périmètre: retard d’un produit? d’une certification? d’un fournisseur? d’une fédération?

    Dans plusieurs contextes, “VRS” renvoie aussi à Virtual Racing School (sim racing). Or, la page officielle de tarification ne parle pas de retard, mais indique que des limites/restrictions de fonctionnalités pourraient évoluer lorsque des offres sortiront de bêta. Ce n’est pas un incident de calendrier en soi, mais ça rappelle un point crucial: une dépendance logicielle “en transition” peut générer de l’incertitude planning.

    Dans le monde infra eSport, un terme fourre-tout comme “VRS” finit souvent par masquer la vraie contrainte: disponibilité d’un environnement serveur, validation du routing, gel de version du jeu, disponibilité des opérateurs (TOps), ou encore fenêtre de tests de charge. Avant de “revoir les plannings”, il faut donc commencer par nommer le livrable et définir le critère de “prêt pour compétition”.

    2) Pourquoi un retard côté serveur force presque toujours un replanning

    Les compétitions ne se calent pas uniquement sur un bracket: elles se calent sur une chaîne de dépendances. Quand l’élément serveur/infra glisse, les impacts typiques sont immédiats: réduction des scrims officiels, raccourcissement de la phase de check-in, et décalage des captations (observer, replays, API stats).

    Techniquement, un “retard VRS” (au sens d’un système serveur ou d’une brique d’organisation) se traduit par un déplacement de jalons: date de freeze (versions), fenêtre de test de latence (p95/p99), validation anti-DDoS, validation des règles réseau (firewall, ports, QoS), ou encore déploiement multi-région si on doit gérer des équipes distribuées.

    Pragmatiquement, les organisateurs doivent arbitrer: maintenir la date publique (au risque de dégrader la qualité compétitive), ou repousser un jalon (au risque de friction marketing/partenaires). Dans l’eSport, où la perception d’équité (ping, jitter, loss) est centrale, la plupart des équipes préfèrent un retard assumé à une compétition “instable”.

    3) Les dépendances administratives: fréquences, sécurité, conformité

    La planification ne dépend pas que du cloud. Pour les grands événements, la logistique radio et la coordination technique peuvent imposer des délais incompressibles. En France, l’ANFR indique qu’une demande d’autorisation pour des fréquences temporaires doit généralement être déposée avec un préavis de 6 semaines, ce qui devient un verrou dur si l’événement implique micro HF, intercom, liaisons vidéo ou talkies.

    Ce type de contrainte est souvent sous-estimé dans l’eSport, surtout quand l’équipe technique vient du “tout online”. Or dès qu’on passe en LAN, studio, ou arène, les dépendances physiques (RF, sécurité, accès, plan de prévention) s’ajoutent à l’infra IT. Un retard “serveur” peut donc être aggravé par un calendrier administratif qui, lui, ne bouge pas facilement.

    Enfin, la conformité et la sécurité peuvent imposer des adaptations. Une publication préfectorale (exemple dans l’Eure) rappelle que les dispositions doivent être adaptées à la manifestation et conformes aux règles de la fédération délégataire. Même si l’eSport n’est pas toujours dans un cadre fédéral identique aux sports traditionnels, le principe est transposable: les règles techniques et de sécurité structurent le planning, qu’on parle de scène, de public, de réseau, ou de procédures d’exploitation.

    4) Gouvernance, fédérations et règles techniques: un calendrier qui se décide aussi “au-dessus”

    Au-delà du terrain, la gouvernance influence le timing. Une réponse du Sénat (30 avril 2026) rappelle que les fédérations délégataires fixent les règles techniques et d’organisation des compétitions. Dans les disciplines structurées, cela signifie que certains jalons (formats, homologations, conditions de participation) arrivent d’un cadre supérieur et peuvent forcer des ajustements.

    On voit la même mécanique dans les appels à candidatures et la planification longue. Par exemple, la Fédération Française de Roller & Skateboard affiche une date limite de candidature pour des événements 2026/2027 au 19 septembre 2026. Même si ce n’est pas de l’eSport, c’est une illustration nette: certains dossiers doivent être verrouillés très tôt, et un retard sur une brique technique peut rendre la candidature ou l’homologation plus risquée.

    Pour l’eSport, cela se traduit souvent par des “deadlines de publication” (règlement, format, serveurs, anti-cheat, conditions de diffusion). Quand un élément VRS est en retard, l’organisateur doit choisir entre publier “incomplet” (risque de rework et de confusion) ou repousser (risque d’érosion de l’attention et du marketing).

    5) Facteurs externes: météo, annulations et dates publiées tardivement

    Les aléas externes restent un motif très concret de replanning. La FFSA a par exemple indiqué qu’une épreuve à Laon avait été annulée en raison de conditions climatiques exceptionnelles. Dans l’eSport, la météo n’affecte pas le ping, mais elle peut affecter la logistique: transport des équipes, disponibilité du site, sécurité du public, ou même la stabilité électrique et la connectivité d’un lieu.

    Autre réalité: de nombreux calendriers ne sont pas “figés” très en amont. Un exemple côté salons (camping-car) indique qu’au 4 juillet 2026, beaucoup de dates 2027 n’étaient pas encore publiées et que les organisateurs annoncent souvent leurs dates 6 à 9 mois à l’avance. Pour un tournoi, cela signifie que certaines fenêtres de salle, de prestataires AV, ou de sponsors se verrouillent tard, ce qui amplifie l’impact d’un retard technique.

    Résultat: quand la brique serveur (ou assimilée) glisse, il ne suffit pas de “décaler d’une semaine”. On doit revalider une chaîne complète: disponibilité du lieu, équipes de prod, slots de diffusion, arbitres, observateurs, partenaires, et fenêtres de tests. Plus l’annonce publique a été faite tôt, plus le coût de modification est élevé.

    6) Replanifier proprement: jalons techniques, buffers et critères de qualité compétitive

    La réponse opérationnelle à un retard “VRS” consiste à transformer l’incertitude en jalons mesurables. Exemple: définir un critère d’acceptation (SLO) pour le match server (crash rate, time-to-recover, p95 latency intra-region, taux de packet loss), puis aligner le calendrier sur la date de validation et non sur une estimation.

    Ensuite, il faut bufferiser les phases à risque: tests de charge, répétitions de production (obs + overlays + API), dry runs réseau, et “jour 0” de rollback. Dans un contexte cloud hosting, cela inclut aussi le temps de mise en place d’une stratégie anti-DDoS, la validation WAF/rate limiting pour les endpoints publics, et la revue des accès (IAM) pour éviter qu’un incident opérationnel ne force une pause en direct.

    Enfin, côté communication, une bonne pratique est de séparer: (1) la date de l’événement, (2) la date de publication du règlement final, (3) la date de disponibilité de l’environnement de practice. On peut maintenir la date de compétition tout en décalant les scrims officiels, ou l’inverse, à condition d’être transparent sur les raisons et sur les objectifs de qualité (équité, stabilité, latence).

    7) Outillage et documentation: standardiser pour limiter le coût du retard

    La maturité planning se joue aussi dans les guides et les checklists. France Esports a publié en 2026 de nouveaux guides pour aider les organisateurs à concevoir, planifier et encadrer un événement. Ce type de documentation est utile pour industrialiser le rétroplanning: responsabilités, points de contrôle, et niveaux de validation.

    Pour les équipes plateforme et les staffs techniques, l’objectif est de rendre le planning “composable”: une brique serveur en retard ne doit pas faire s’effondrer tout le projet. On y arrive via des interfaces stables (API, tooling d’admin), un environnement de staging proche de la prod, et des procédures d’exploitation répétables (IaC, runbooks, observabilité).

    En pratique, cela permet de convertir un retard subi en décision: réduire la portée (format, maps, features spectateur), changer de topologie (région, fournisseur, bare metal vs cloud), ou ajuster les contraintes réseau (peering, routing, private interconnect). L’important est de préserver l’essentiel: intégrité compétitive, expérience joueur, et capacité de reprise en cas d’incident.

    Le thème “Le retard des VRS pousse les organisateurs à revoir leurs plannings” ne renvoie pas, à date, à une actualité clairement sourcée. Mais la situation qu’il décrit est très réelle dans l’eSport: quand une dépendance critique côté serveurs, outillage ou validation externe glisse, le calendrier doit être recalculé à partir des jalons techniques et des contraintes administratives.

    La meilleure approche reste pragmatique: clarifier ce que “VRS” signifie dans votre contexte, définir des critères de “prêt pour compétition”, intégrer les délais incompressibles (ex. préavis ANFR, règles de sécurité, gouvernance), et structurer le rétroplanning avec buffers et points de décision. C’est ce cadre qui transforme un retard en ajustement contrôlé plutôt qu’en crise de dernière minute.
  • Jouer 5v5 sur des serveurs dédiés en moins d’une minute, sans client lourd

    Jouer 5v5 sur des serveurs dédiés en moins d’une minute, sans client lourd

    Dans l’eSport, la différence entre « on scrim » et « on a scrimé » se joue souvent avant même le premier round : création de lobby, distribution des accès, allocation de serveur, vérification anti-triche, et coordination des joueurs. Quand ces étapes imposent un client tiers lourd, des mises à jour et des frictions d’onboarding, le temps “hors-jeu” explose,avec un impact direct sur la discipline, la qualité des entraînements et la réactivité en compétition.

    La tendance 2026 va dans l’autre sens : du web-first et du browser-native pour lancer du 5v5 plus vite, tout en conservant le standard compétitif du serveur dédié. L’objectif est clair : entrer en match en moins d’une minute (ou quelques minutes selon les cas), sans installer un client supplémentaire, sans sacrifier l’autorité serveur, la collecte de preuves (démos/replays) et la gouvernance (rôles, règles, régions).

    1) Pourquoi “moins d’une minute” change l’économie d’un 5v5

    En 5v5 tactique, la latence organisationnelle (setup) coûte aussi cher que la latence réseau. Une équipe qui perd 6,10 minutes par session en création de match, patchs de clients tiers, et invitations éparses, finit par réduire le volume d’itérations : moins de rounds joués, moins d’expérimentations tactiques, moins de VOD à analyser.

    Le “time-to-first-round” devient donc un KPI opérationnel. Il touche les staffs (planification), les ingénieurs (outillage), et les organisateurs (ponctualité, no-shows). À l’échelle d’un split, la différence entre une mise en route instantanée et une mise en route laborieuse se transforme en heures d’entraînement net.

    Des plateformes annoncent explicitement ce positionnement. QuickFrag, par exemple, met en avant un matchmaking CS2 5v5 avec serveurs dédiés « usually in under 60 seconds », et une approche browser-first où l’on ouvre le matchmaking dans le navigateur, rejoint/crée un lobby, puis on se connecte dès que le serveur démarre.

    2) “Sans client lourd” ne veut pas dire “sans exigences compétitives”

    « Sans client lourd » signifie surtout : pas de couche supplémentaire à installer pour orchestrer le match (lobby, queue, règles, droits, régions, accès serveur). Dans la plupart des écosystèmes FPS, le client de jeu principal reste nécessaire, mais l’outillage qui entoure le match peut devenir web-only, donc plus léger à adopter et plus simple à maintenir.

    Il existe aussi un second modèle : le jeu réellement browser-native. Counter-Pump se décrit comme un FPS tactique 5v5 “browser-native” et “server-authoritative”, avec un moteur serveur en Go et un rendu WebGL2, ainsi qu’un matchmaking Glicko-2. Ici, l’absence de client lourd n’est plus seulement « pas de launcher tiers » : c’est l’expérience complète qui vit dans le navigateur.

    Dans les deux cas, les exigences restent identiques : cohérence des règles, résistance à la triche, observabilité, et stabilité des serveurs. La légèreté côté utilisateur doit coexister avec une exécution robuste côté serveur,sinon on gagne 45 secondes au lancement pour perdre 10 minutes en match instable.

    3) Le modèle technique : client → serveur dédié, et pourquoi il reste la base

    Le schéma classique documenté par le cloud (modèle “Game Client Connects to Dedicated Game Server”) reste la référence pour le 5v5 moderne : les clients se connectent à une instance dédiée, isolée, dimensionnée pour un tickrate et une charge réseau déterminés. Cette séparation permet de mieux contrôler les performances, la sécurité, et la répétabilité.

    Ce qui change avec les offres web-first, ce n’est pas le fondement technique, mais l’orchestration : création/assignation d’instance, configuration de la région, génération des liens d’accès, et publication des résultats. En pratique, vous externalisez la “salle d’attente” et le “dispatch” vers le web, tout en conservant la partie critique (simulation) sur un serveur dédié.

    Ce modèle s’aligne aussi avec les principes d’autorité serveur : quand le serveur arbitre l’état du jeu, on réduit l’espace de manipulation côté client. Roblox rappelle ce bénéfice via des APIs dédiées et une exécution serveur autoritative visant à réduire les tricheries et à alléger la logique client,un principe transposable aux environnements compétitifs, même si les implémentations varient selon les jeux.

    4) Provisioning à la demande : la vraie mécanique derrière la promesse

    Lancer un 5v5 « en moins d’une minute » suppose un provisioning automatisé : réservation d’une machine/VM, déploiement d’une image serveur, configuration réseau (ports, firewall), attachement éventuel de protection DDoS, puis signal “ready” au lobby. C’est une chaîne d’automatisation,pas une simple page web.

    5Stack Quick Play illustre ce pattern : la documentation décrit un système capable de provisionner automatiquement un serveur à la demande dans la région choisie, ou de fonctionner sur des serveurs dédiés/tiers. L’idée est de transformer l’allocation d’infrastructure en action utilisateur (“go next”) plutôt qu’en tâche d’admin.

    Cette logique se retrouve dans des plateformes orientées “fast lane into a game” (5v5, 2v2, scrims instantanés), mais aussi dans des approches plus communautaires : Sofa League se présente comme “Discord-native” avec “No download, no third-party client”, et allocation instantanée de serveurs dédiés. NeatQueue annonce aussi pouvoir lancer des formats de 1v1 à 5v5 “in minutes” via Discord et web, en automatisant la publication des résultats.

    5) Gouvernance, anti-cheat, démos : le triptyque qui rend le 5v5 exploitable

    La vitesse n’a de valeur que si l’après-match est exploitable. Pour un staff, un 5v5 “rapide” doit produire des artefacts : score validé, logs, et idéalement démo/replay. hubmix met par exemple en avant du 5v5 sur ses propres serveurs avec anti-cheat, ELO, et démo de chaque round,un ensemble cohérent pour l’analyse et la contestation.

    Sur le plan opérationnel, le web-first réduit aussi la friction d’administration. Le dépôt GitHub “CSGO-Matchmaking” documente un panneau complet accessible via navigateur, avec “no game client needed” pour la partie admin/gestion. Même si le contexte est spécifique, le principe est universel : séparer le contrôle (web) de l’exécution (serveur) accélère la résolution d’incidents et l’autonomie des organisateurs.

    Enfin, les systèmes de rating (ELO, Glicko-2) et de matchmaking imposent des garanties d’intégrité : gestion des abandons, preuves, cohérence des règles. Counter-Pump cite Glicko-2 ; d’autres plateformes se positionnent sur l’ELO. Dans tous les cas, la qualité du compétitif dépend autant des politiques (sanctions, détections) que de l’architecture.

    6) Serveur dédié vs VPS : latence, contrôle, et charge d’exploitation

    Pour des matchs 5v5, le serveur dédié reste souvent le choix “propreté” : ressources non partagées, moins de variabilité, et meilleure maîtrise du réseau. OVHcloud rappelle qu’un serveur dédié offre plus de contrôle matériel qu’un VPS, au prix d’une gestion plus directe,un trade-off qui réapparaît dès qu’on cherche un tick stable et une latence prévisible.

    Le VPS garde un intérêt pour des environnements flexibles (tests, petites ligues, régions de secours), mais l’isolation et la constance du dédié facilitent la standardisation des performances. Pour les organisateurs, cela simplifie aussi la communication : mêmes paramètres, mêmes attentes, moins d’aléas.

    Les offres infrastructure évoluent également. Fusiora met en avant (annonce 2026) des VPS/serveurs dédiés gaming avec DDoS permanent et NVMe, ce qui répond à deux points sensibles du compétitif : la résilience (attaques) et la vitesse d’I/O (démos, logs, snapshots). Dans un modèle à la demande, ces caractéristiques peuvent faire la différence entre un serveur “ready” en 45 secondes et un serveur “ready” en 2 minutes.

    7) Implications tactiques : quand la friction baisse, le niveau monte

    Réduire le temps d’accès au 5v5 change le contenu même des entraînements. Les équipes peuvent enchaîner plus de scénarios, isoler des segments (pistolets, mid-rounds), et répéter davantage,ce qui augmente mécaniquement la qualité des décisions sous pression.

    Pour les ingénieurs et admins, le bénéfice est la standardisation : régions définies, règles fixes, templates de serveur, et monitoring identique match après match. Une approche web-first facilite la diffusion de ces standards : une URL de lobby, une configuration validée, et un serveur dédié alloué automatiquement.

    QuickFrag illustre bien ce couplage “friction minimale + serveur dédié” : le matchmaking s’ouvre dans le navigateur (browser-first), le lobby se gère immédiatement, puis les joueurs se connectent dès que l’instance est prête,avec la promesse récurrente d’un démarrage « usually in under 60 seconds ». Ce type de flux réduit les micro-ruptures qui, en pratique, détruisent l’intensité d’une session.

    Jouer 5v5 sur des serveurs dédiés en moins d’une minute, sans client lourd, n’est pas un slogan : c’est la combinaison d’un modèle d’orchestration web-first, d’un provisioning à la demande, et d’une exécution serveur autoritative. Les exemples récents,du browser-native (Counter-Pump) à l’orchestration rapide pour des FPS existants (QuickFrag, 5Stack, Sofa League),montrent une convergence nette du marché.

    Pour les équipes et organisateurs, la question à se poser est pragmatique : où se situe votre friction (onboarding, région, anti-cheat, preuves, admin) et quel maillon automatiser en premier. La tendance 2026 indique une direction : déplacer le maximum de “pré-match” vers le navigateur, tout en renforçant ce qui compte en match,serveurs dédiés, intégrité, et observabilité.

  • Repenser les rotations d’équipe après la nouvelle physique des fumigènes

    Repenser les rotations d’équipe après la nouvelle physique des fumigènes

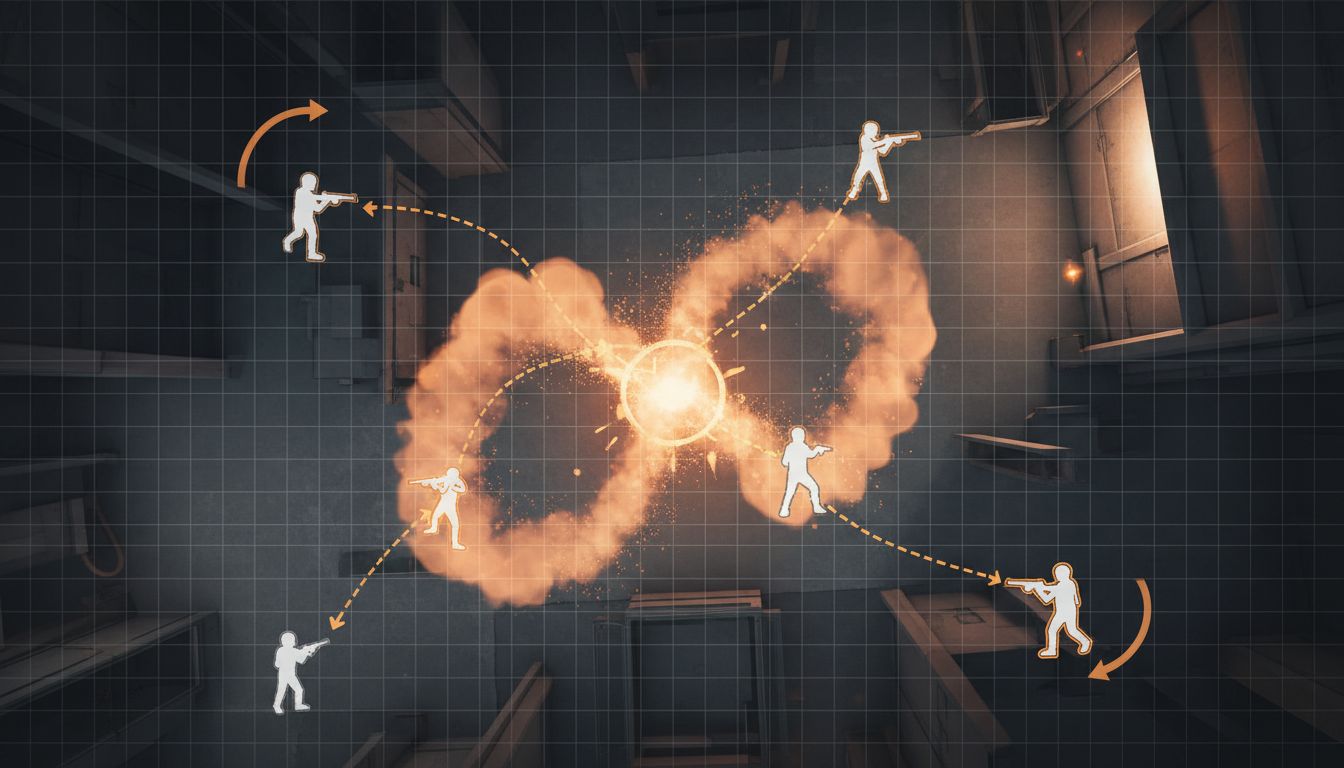
    La “nouvelle physique des fumigènes” ne change pas seulement la visibilité à l’écran : elle modifie la manière dont les joueurs perçoivent l’espace, évaluent le risque, et synchronisent leurs actions sous contrainte de temps. Pour les staffs eSports, c’est un signal clair : les rotations d’équipe (micro-rotations de rôles, timings de reprise, bascules de contrôle de zones) doivent être repensées comme un système perception,décision,action.

    Chez QuickFrag, on aborde le sujet avec une grille pragmatique : infrastructure (latence, stabilité, télémétrie), protocoles d’équipe (rôles, redondance), et impacts tactiques. Les travaux 2026 sur l’évacuation sous fumée, la signalisation dynamique et la coordination en environnement dégradé offrent des analogies exploitables : la fumée perturbe d’abord le “choix de sortie”, puis la cohésion des groupes, et enfin la robustesse des routines.

    1) La fumée n’est plus un simple écran : c’est un perturbateur de décision

    Les études 2026 en réalité virtuelle rappellent un point souvent sous-estimé : l’étape fondatrice n’est pas la dynamique de déplacement, mais le choix de sortie. Transposé au jeu, cela correspond au choix de trajectoire (retrait, push, split, re-contact) et à la sélection de la “porte” tactique (choke, pivot, lurk). Si la fumée altère ce choix initial, tout le reste (timings, trades, utilitaire) se dégrade en cascade.

    Une autre synthèse VR immersive 2026 relie explicitement concentration de fumée, densité (congestion), perception visuelle et trajectoires de mouvement. La conclusion est opérationnelle : la rotation devient un problème de boucle perception-action, pas un simple calcul de vitesse. En match, cela veut dire qu’un joueur peut “arriver à l’heure” mais avec une compréhension erronée de l’état du site (position adversaire supposée, angle non-clear, timing de flash décalé).

    Conséquence pragmatique pour les équipes : les calls de rotation doivent intégrer une couche “qualité de perception”. Dans un environnement enfumé, un call binaire (“rotate B”) est moins fiable qu’un call structuré (“rotate B via CT, éviter le choke X, regrouper à Y, confirmation info à t+2s”). Vous ne compensez pas la fumée par plus de vitesse, mais par plus de validation et de guidage.

    2) Priorité aux sorties “sans fumée” : comment l’exploiter et s’en protéger

    Une étude 2026 sur la prise de décision en évacuation montre que, face à un passage clair et un passage enfumé, les participants privilégient fortement la sortie sans fumée. Dans un match, ce biais se traduit par une préférence naturelle pour la ligne “lisible” : rotations par zones ouvertes, retakes par couloirs non contestés, ou regroupements par les routes à meilleure visibilité.

    Le même résultat souligne un point crucial : les signaux trompeurs augmentent le risque davantage que l’effet de foule. Dans le jeu, cela ressemble à une smoke qui “promet” la sécurité (passage supposé safe) mais cache une crossfire, ou à une info vocale imprécise (“c’est free”) qui déclenche une rotation collective dans un piège. Le problème n’est pas seulement l’adversaire, c’est la crédibilité de la signalisation (mini-map mental, comms, timings).

    Plan d’action : formalisez des règles de validation avant de “choisir la sortie”. Par exemple : (1) un rôle “capteur” (IGL, support, ou lurker) annonce l’incertitude, (2) un second rôle confirme par utilitaire (flash info, jump spot, drone/scan selon le jeu), (3) seulement ensuite le reste du groupe commit. Cette redondance limite l’impact des signaux trompeurs induits par la fumée.

    3) Groupes qui se cassent en duos : adapter la rotation à la fragmentation réelle

    Une étude 2026 en VR observe que les groupes se séparent fréquemment en sous-groupes de 2, et que ces sous-groupes sont particulièrement sensibles à la fumée avec une forte tendance à l’évitement. En scrim, cela correspond à une réalité connue : sous pression et sans vision, les joueurs se “collent” à un buddy (trade partner) et le 5-man se fragmente en 2+2+1.

    Le risque est double : (a) perte de masse critique au point de contact (retake trop léger), (b) incohérence temporelle (un duo évite la smoke et arrive 3 secondes plus tard, cassant les timings de flash et de crossfire). La nouvelle physique des fumigènes amplifie ce phénomène en augmentant la variance de perception : deux joueurs au même endroit n’ont pas forcément la même lecture de l’espace.

    Rotation pragmatique : assumez la fragmentation plutôt que de la subir. Définissez des “paquets” stables (duos) avec responsabilités explicites : Duo A = prise d’info + fixation, Duo B = pression/prise d’angle, Solo = ancre/anti-flank. Ensuite, imposez des points de resynchronisation (waypoints) hors fumée où l’équipe “recompose” le 5-man. On ne demande pas “restez groupés” ; on donne une mécanique de regroupement robuste.

    4) Signalisation dynamique et guidage multimodal : la playbook doit devenir adaptative

    Les travaux 2026 sur la sécurité incendie en stations de métro convergent : la signalisation statique s’adapte mal lorsque fumée et congestion évoluent vite. Dans un match, un plan figé (“si smoke A alors rotate B”) casse dès que la smoke n’a pas la même densité, durée, ou interaction avec la géométrie (angles, hauteurs, pentes, escaliers, rampes).

    À l’inverse, un cadre 2026 combinant fumée + guidage dynamique (coordination par apprentissage multi-agent et gestion dynamique de la signalisation) réduit le temps d’évacuation de 37% et le risque de 68% dans des scénarios complexes à double foyer. Sans prétendre “faire du RL” en mid-round, l’idée est claire : la meilleure performance vient d’un guidage qui se met à jour en temps réel, basé sur l’état local (vision, bruit, contacts, congestion).

    Traduction QuickFrag : mettez en place un guidage multimodal. (1) Visuel : conventions de mini-map et calls standardisés (noms d’angles, zones, niveaux). (2) Audio : cadence et format des comms (qui parle, quand, et en combien de mots). (3) Tactile/rythme : routines de timing (“à la deuxième seconde après extinction, on re-peek”). Le but est de fournir plusieurs canaux de correction quand la fumée dégrade un canal (la vision).

    5) Rôles redondants, relais courts : l’antidote aux comportements non adaptatifs

    Les modèles 2026 d’évacuation d’urgence montrent que des comportements non adaptatifs liés à l’intensité émotionnelle augmentent le désordre de la foule. En compétition, l’équivalent est le tilt micro-décisionnel : re-peek inutile, sur-rotation, ou push isolé “pour compenser”. Sous fumée, ces comportements coûtent plus cher car l’équipe ne voit pas immédiatement l’erreur, donc la corrige trop tard.

    D’autres travaux 2026 soulignent l’importance de l’hétérogénéité psychologique : des individus adaptatifs (guides, personnels formés) limitent la propagation de la panique. Dans une équipe, cela plaide pour des rôles “guide” explicites et des relais courts : un seul leader vocal en continu fatigue et perd en précision, surtout quand la fumée impose davantage de micro-ajustements.

    Implémentation concrète : (a) définissez un leader macro (plan) et un leader micro (exécution dans la fumée) avec des fenêtres de prise de parole alternées ; (b) imposez des “relais” de décision toutes les X secondes dans les phases enfumées (ex. 3,5s) ; (c) doublez les fonctions critiques (qui compte les utilitaires, qui confirme le timing de defuse/plant, qui check le flank). La redondance n’est pas un luxe : c’est une assurance contre la perte de perception.

    6) Géométrie, pentes et congestion : une rotation ne peut pas être uniforme

    Un modèle 2026 de simulation de stampede indique une résistance anisotrope et une forte dépendance à la pente. Même si le contexte est la foule, l’enseignement est transposable : la géométrie impose des “coûts” de mouvement non linéaires. Dans les maps compétitives, escaliers, rampes, couloirs étroits et portes créent des congestions ; la fumée accentue ces goulots car elle ralentit l’acquisition d’information et augmente l’hésitation.

    Traiter toutes les rotations comme équivalentes (mêmes timings attendus, mêmes fenêtres de trade) devient faux dès que la fumée s’accumule sur un choke ou un plan incliné. L’équipe arrive en ordre différent, avec des espacements irréguliers, et donc des trades moins fiables. Les “micro-collisions” (-block) augmentent et la discipline de spacing devient une compétence à part entière.

    Approche pragmatique : cartographiez vos “zones de résistance” (où la rotation se déforme) et créez des variantes de playbook par géométrie : version couloir étroit, version rampe, version double-niveau. Ajoutez des règles de spacing (“1,5 mètre virtuel”, “ne pas doubler l’entrée”) et des points d’attente hors fumée. Une rotation bien pensée n’est pas la plus rapide, c’est celle qui conserve la forme du groupe et la capacité de trade.

    7) Télémétrie, réseau et différenciation des fumées : vers une exploitation plus fiable

    QuickFrag insiste sur un point d’infra : quand la fumée change la perception, la moindre instabilité réseau amplifie la divergence d’état entre joueurs (desync cognitif : “je ne vois pas la même chose que toi”). Latence, jitter et pertes influencent la confiance dans les comms (“tu dis qu’il est passé, mais je ne l’ai pas vu”). Dans les rounds enfumés, la tolérance à l’erreur est plus faible ; stabiliser la qualité de service devient un levier tactique, pas seulement “confort”.

    À l’échelle événementielle, la capacité à distinguer les sources d’aérosols et d’effets visuels peut aussi compter. Une étude 2026 sur la fumée de feux d’artifice identifie des marqueurs chimiques (enrichissement en chlore et métaux comme Ba, Sr, Cu) permettant de différencier les fumées pyrotechniques d’autres aérosols. L’analogie opérationnelle : en production (LAN, arènes, studios), être capable de classifier rapidement un incident “fumée” (effet scénique vs problème ventilation) aide à décider des rotations de staff et des procédures sans ambiguïté.

    Recommandation : instrumentez. Côté serveur/plateforme : métriques de latence/jitter corrélées aux phases d’utilitaire. Côté équipe : tags temporels sur comms clés (début smoke, fin smoke, contact). Côté organisateur : checklists et capteurs environnementaux si effets scéniques. Plus vos signaux sont fiables, moins la fumée crée de décisions erratiques.

    Repenser les rotations d’équipe après la nouvelle physique des fumigènes revient à accepter une réalité : la fumée agit d’abord sur la perception, puis sur le choix de sortie, puis sur la coordination. Les résultats 2026 convergent vers des relais plus courts, des rôles redondants, une signalisation dynamique et une formation orientée “lecture du risque”, plutôt qu’une obsession de vitesse.

    Le plan pragmatique pour les équipes et les staffs techniques est clair : stabiliser l’infrastructure (latence/jitter), rendre la playbook adaptative (guidage multimodal), structurer la fragmentation (duos + points de resync), et outiller la décision (validation, crédibilité des signaux). La fumée ne se “subit” pas : elle se gère comme un système, et les rotations deviennent alors un protocole robuste, reproductible et mesurable.

  • Améliorer sa visée grâce aux hubs d’entraînement du workshop

    Améliorer sa visée grâce aux hubs d’entraînement du workshop

    Dans CS2, « avoir une bonne visée » ne se résume pas à enchaîner des heures de deathmatch. Les guides 2026 convergent vers une approche plus pragmatique : isoler des compétences (placement du viseur, stop-and-shoot, contrôle de recul, lecture d’angles) via des hubs d’entraînement du Workshop, puis transférer ces acquis en conditions réelles.

    Chez QuickFrag, on s’intéresse aussi à la dimension infrastructure : une routine structurée et courte est plus reproductible, plus mesurable, et réduit les biais liés à la fatigue, aux variations de FPS et à la latence. L’objectif est simple : rendre la performance plus stable, donc plus exploitable en match et en scrim.

    1) Pourquoi les hubs d’entraînement du Workshop accélèrent la progression

    Les hubs d’entraînement du Workshop sont efficaces parce qu’ils imposent de la spécificité. Plutôt que d’espérer « tomber » sur des situations utiles en DM, on répète volontairement un geste précis (première balle, micro-ajustement, transition de cible) jusqu’à ce qu’il devienne automatique.

    Les contenus récents (y compris du côté d’Aimlabs) rappellent que l’isolement des compétences et la surcharge progressive sont le cœur d’un entraînement efficace. En pratique : même drill, même durée, objectif chiffré, difficulté qui monte progressivement (vitesse, taille des cibles, pénalité de mouvement, etc.).

    Autre avantage : les hubs modernes couvrent plusieurs axes (aim, recoil, prefire, movement, utility). On sort d’une logique « tout DM » pour construire une routine plus complète, cohérente avec la réalité du duel sur CS2 : placement du viseur, stop-and-shoot, timing de peek et target switching.

    2) Le socle : crosshair placement et contre-strafe avant les flicks

    Les guides CS2 2026 le martèlent : le crosshair placement est l’habitude la plus rentable. Un bon placement réduit la distance à corriger au moment du contact, donc augmente la probabilité de gagner le duel avec une première balle propre, même sous pression.

    Le second multiplicateur est le counter-strafing (s’arrêter correctement avant de tirer). Beaucoup de « mauvais aim » vient en réalité d’un tir déclenché en mouvement, donc d’une précision mécaniquement dégradée. Travailler le stop-and-shoot dans un hub est souvent plus rentable que de chercher des flicks spectaculaires.

    Concrètement, votre routine devrait prioriser : (1) arriver viseur à hauteur tête sur les lignes probables, (2) stop net, (3) tir, (4) reposition. Les flicks et le tracking sont des compléments, pas des fondations.

    3) Yprac Hub : pré-visée, prefires et angles spécifiques aux maps

    Yprac Hub reste une référence en 2026 pour travailler le prefire et les angles d’une carte précise. L’intérêt n’est pas seulement de « tirer des bots », mais de répéter des séquences d’angles réels : comment entrer, où placer le viseur avant de voir l’adversaire, et comment enchaîner les lignes.

    Pour une équipe eSports ou un staff technique, l’impact est mesurable : les routines Yprac structurent le crosshair placement par map, et standardisent des micro-décisions (hauteur du viseur, ordre des clears, tempo). En match, cela se traduit par moins de corrections tardives et plus de duels pris sur un avantage mécanique.

    Approche recommandée : choisissez 1 carte à la fois, 10 à 15 minutes, avec un objectif simple (ex. « réduire les ratés de première balle sur 3 séquences d’angles »). La stabilité prime sur le volume.

    4) GGPredict Training Hub : échauffement “all-in-one” et routine légère

    GGPredict Training Hub est souvent présenté comme un hub “all-in-one” pour l’échauffement. Les guides récents le recommandent pour une séance courte (10,15 minutes), notamment si vous cherchez une routine simple, reproductible, et relativement adaptée aux PC modestes.

    L’intérêt opérationnel : un échauffement fixe réduit la variabilité. À infrastructure identique, vous comparez plus facilement vos métriques d’un jour à l’autre (précision, temps de réaction, constance). C’est la logique « routine courte et mesurable » devenue standard dans les recommandations 2026.

    Pour maximiser le transfert, gardez l’échauffement orienté duel : premières balles, micro-ajustements, target switching. Évitez de transformer l’échauffement en session longue qui entame votre lucidité pour les scrims.

    5) Recoil Master : stabiliser le spray et la conversion en situation réelle

    Recoil Master reste cité en 2026 pour travailler le spray et le contrôle de recul, notamment sur AK/M4. Le spray n’est pas un exercice « isolé » inutile : en match, il conditionne la capacité à convertir un avantage (premier hit) en frag, surtout sur des timings de peek serrés.

    Le bon usage consiste à passer du pattern « appris » à la stabilisation en contexte : courtes rafales, transitions entre tap/burst/spray, et récupération de la ligne de visée. Vous cherchez la régularité, pas la perfection de laboratoire.

    Mesurez : dispersion, temps pour revenir sur la cible après 5,10 balles, et capacité à arrêter le spray à temps. Ce sont des métriques plus proches du duel réel que « réussir 30 balles au mur » sans contrainte.

    6) Fast Aim Reflex Training : flicks, tracking et micro-ajustements

    Fast Aim Reflex Training est souvent recommandé pour les flicks, le tracking et les micro-ajustements. Utilisé correctement, il complète bien le travail de pré-visée (Yprac) et de spray (Recoil Master), en ciblant des sous-compétences spécifiques.

    Pour rester pragmatique, gardez en tête la hiérarchie du transfert : le crosshair placement + stop-and-shoot gagnent le plus de duels. Les flicks et le tracking sont utiles quand le duel devient chaotique (wide peek, multi-target, changement de hauteur), mais ils ne doivent pas prendre tout le temps d’entraînement.

    Structure efficace : courtes séries avec timer, objectifs comparables, et surcharge progressive (cibles plus petites, rythme plus élevé, moins de temps par cible). Si la qualité s’effondre, réduisez la difficulté : la régularité vaut mieux qu’une séance « héroïque » non reproductible.

    7) Construire une routine 2026 : courte, structurée, et orientée transfert

    Un guide 2026 sur la progression en visée via les Workshop maps recommande de répartir l’entraînement entre aim, utility, movement et game sense, plutôt que de “grind” uniquement le deathmatch. Il propose aussi une routine hebdomadaire : 10,15 minutes d’échauffement avant chaque session, 2,3 sessions d’aim dédiées par semaine, et 1,2 sessions de travail utility.

    En format quotidien, les routines « 15 minutes » sont mises en avant : par exemple 8 minutes de drills Workshop suivies de 7 minutes de deathmatch. Le Workshop construit le geste propre (contrainte contrôlée), le DM force l’adaptation sous stress (angles imprévus, timings variables, bruit informationnel).

    Point important : Aim Botz est souvent cité comme repère historique, mais a été retiré du Workshop en 2024. En 2026, on le mentionne surtout comme référence, remplacée par des hubs plus modernes (GGPredict, Yprac, maps reflex) et des approches plus mesurables.

    8) Mesurer la progression : métriques, benchmarks et hygiène de performance

    Les guides 2026 insistent sur la mesure : timer, objectif précis, métriques comparables. C’est aussi l’approche d’Aimlabs avec ses benchmarks et la personnalisation des drills (tap, track, switch) pour isoler finement les faiblesses. Même si vous ne sortez pas de CS2, la logique reste valable : standardiser pour comparer.

    Des benchmarks communautaires (classements, scores, séries) sont utiles pour éviter l’auto-illusion. Vous ne cherchez pas seulement « de bonnes sensations », mais une amélioration observable sur la première balle, la précision, et la stabilité sur plusieurs semaines, un point régulièrement rapporté par des ressources communautaires avec entraînement quotidien structuré.

    Enfin, n’oubliez pas le contexte QuickFrag : la qualité de l’environnement (FPS stables, input lag, latence maîtrisée) influence la lecture du progrès. Pour des équipes et des organisateurs, stabiliser les conditions (serveur, tick/paramètres, réseau, PCs) réduit le bruit expérimental et rend vos routines réellement exploitables.

    Améliorer sa visée grâce aux hubs d’entraînement du Workshop revient à traiter l’aim comme une compétence ingénierable : décomposer, isoler, mesurer, puis réintégrer en situation réelle via le deathmatch et les matchs. Les outils 2026 (Yprac Hub, GGPredict Training Hub, Recoil Master, Fast Aim Reflex Training) couvrent l’essentiel, à condition de les utiliser avec une intention claire.

    Si vous ne deviez retenir qu’une ligne directrice : priorité au crosshair placement et au counter-strafing, puis seulement ensuite aux drills de flick/tracking. Avec des sessions courtes, structurées et répétables, la progression devient plus régulière, plus lisible, et surtout plus transférable en compétition.

  • Les prêts et promotions d’académies redessinent l’équilibre des effectifs

    Les prêts et promotions d’académies redessinent l’équilibre des effectifs

    Dans le football moderne, les prêts et les promotions issues des académies ne sont plus des variables d’ajustement marginales : elles reconfigurent l’équilibre des effectifs, la gestion du risque sportif et la capacité d’investissement. Pour les structures eSports et tech de QuickFrag, le parallèle est direct : on parle d’optimisation de “capacity planning”, de réduction de la latence décisionnelle (temps de jeu, exposition, progression) et de pipelines de talents qui doivent rester observables et gouvernés.

    La nouveauté, c’est que cette reconfiguration s’appuie désormais sur des flux financiers plus traçables et plus automatisés. La FIFA affirme que sa chambre de compensation a “transformé” la transparence financière du marché des transferts en centralisant les paiements liés à la formation, et elle estime à près d’USD 1 milliard les “training rewards” distribués depuis novembre 2022. Résultat : l’académie devient à la fois une unité de production sportive et un actif économique dont la valeur se mesure, se sécurise et se monétise.

    1) Les prêts comme mécanisme de régulation d’effectif (et de minutes jouées)

    L’UEFA note que l’usage des prêts s’est développé pendant et après la pandémie, lorsque le marché des transferts s’est contracté et que les clubs ont cherché des solutions pour gérer leur effectif sans immobiliser trop de capital. Dans une logique pragmatique, le prêt devient un contrat “à latence faible” : on externalise des minutes de jeu tout en conservant des options de rappel, de valorisation et de revente.

    Mais les règles de prêts varient fortement selon les pays, les divisions et l’existence d’équipes réserves, souligne aussi l’UEFA. Cela crée des stratégies d’effectif radicalement différentes : certains clubs “bufferisent” leurs jeunes via une réserve compétitive, d’autres doivent les prêter pour éviter une stagnation sportive, un point qui pèse sur la trajectoire de développement et sur la valeur de marché.

    Dans un effectif, le prêt agit comme un répartiteur de charge : il évite la congestion sur des postes clés et réduit le risque de baisse de performance dû au manque de rythme. C’est une logique connue des ingénieurs plateforme : quand la capacité est saturée, on déporte la charge, mais on garde une observabilité stricte (temps de jeu, niveau, exposition, blessure) pour décider du “scaling” au retour.

    2) Les académies comme actifs économiques : la preuve par la compensation de formation

    Le cadre FIFA RSTP rappelle que les mécanismes de compensation de formation et de solidarité existent pour rémunérer les clubs impliqués dans le développement d’un joueur. Ce principe, longtemps perçu comme un filet de sécurité, devient un levier structurant dès lors que les paiements sont industrialisés et que la traçabilité réduit les frictions.

    La FIFA estime à près d’USD 1 milliard les “training rewards” distribués depuis novembre 2022 via sa chambre de compensation. Elle met en avant une transformation de la transparence financière : centralisation, automatisation, et donc diminution des “pertes” dues à l’opacité ou aux délais. Pour un club formateur, c’est l’équivalent d’un cashflow plus prévisible, qui peut être réinvesti dans l’infrastructure de formation (staff, data, médical, hébergement, préparation).

    Les chiffres liés à la Coupe du monde 2026 illustrent aussi l’effet d’échelle : les transferts de 530 joueurs appelés ont généré USD 221 millions en indemnités de formation et contributions de solidarité, au bénéfice de clubs formateurs de 46 des 48 sélections engagées. Et même hors de cette vitrine, les transferts de joueurs non participants ont généré USD 768 millions supplémentaires depuis la mise en place de la chambre de compensation. Autrement dit : la valeur d’une académie ne dépend plus uniquement de “sortir un titulaire”, mais d’alimenter un réseau de trajectoires transférables.

    3) Du “loan star” au produit d’académie : un pipeline de talents industrialisé

    The Guardian a récemment décrit plusieurs “loan stars” issus d’académies de Premier League, montrant comment le prêt sert à offrir du temps de jeu aux jeunes talents plutôt que de les laisser bloqués sur le banc. Ce changement est crucial : les minutes jouées deviennent une métrique de progression, de valorisation et d’évaluation, comme le seraient des cycles CPU consommés ou des requêtes servies pour valider un service en production.

    En parallèle, le Guardian souligne que les clubs de Premier League ciblent de plus en plus les joueurs d’académie des clubs de l’EFL, alimentant le débat sur la compensation financière et l’équilibre compétitif. Ici, la tension est systémique : la “couche haute” du marché aspire les talents plus tôt, et la régulation (compensations, solidarités, règles nationales) devient la QoS qui évite l’effondrement de l’écosystème.

    Le Premier League Futures programme met aussi en avant des trajectoires alternatives : une partie importante des jeunes formés ne devient pas pro en première équipe, mais reste valorisable dans d’autres filières (divisions inférieures, coaching, performance, analyses). Cette réalité renforce l’intérêt d’un pilotage de pipeline : un club ne gère pas un unique chemin “first team”, mais un portefeuille de sorties, chacune avec un rendement sportif ou financier potentiel.

    4) EPPP, recrutements entre élites et recomposition de l’équilibre des effectifs

    La Premier League rappelle que l’EPPP, lancé en 2012, structure l’ensemble de la formation des jeunes joueurs en Angleterre, avec plus de 90 clubs professionnels investissant dans des académies sous licence. En pratique, cela standardise les processus, augmente la qualité moyenne des profils formés, et rend les promotions d’académie plus “interopérables” entre clubs.

    Un article de 2026 sur Manchester City et Chelsea met en lumière comment les “graduates” d’académies influencent directement les recrutements entre clubs d’élite. Cette dynamique redessine l’équilibre des effectifs : au lieu d’acheter uniquement des profils “finis”, les clubs intègrent des joueurs déjà acclimatés à des exigences de haut niveau (intensité, data, nutrition, tactique), ce qui réduit le temps d’intégration et les risques de mismatch.

    En conséquence, les effectifs se construisent davantage comme des graphes que comme des listes : un noyau de titulaires, une couche de rotation, puis un ensemble de joueurs en orbite (prêts, retours, ventes avec clauses), alimenté par l’académie. La profondeur d’effectif n’est plus seulement “quantitative”, elle devient “configurable”, avec des options contractuelles qui ressemblent à des mécanismes d’orchestration.

    5) Mondialisation du prêt : la MLS et la normalisation d’un outil de gestion

    Le Guardian rapporte qu’en MLS, les restrictions sur les prêts interclubs ont été assouplies pour multiplier les opportunités de temps de jeu. C’est un signal fort : le prêt n’est pas une particularité européenne, mais un outil de gestion d’effectif qui se généralise quand les ligues cherchent à accélérer le développement des jeunes et à améliorer le niveau compétitif.

    Ce mouvement favorise une circulation plus fluide des profils et une meilleure allocation des minutes. Dans une ligue avec contraintes spécifiques (règles d’effectif, plafonds, slots), assouplir le prêt revient à améliorer la “gestion de capacité” globale : les joueurs progressent en environnement compétitif au lieu de rester sous-utilisés, et les clubs réduisent le coût d’opportunité.

    Pour les organisations orientées performance, cela implique d’investir dans la mesure : suivi de charge, blessures, performance contextuelle, compatibilité tactique. Un prêt “réussi” est rarement un hasard ; c’est une opération pilotée par données, comparable à un déploiement contrôlé où l’on surveille en continu la stabilité et les gains.

    6) Investissement institutionnel : Forward, Talent Development Scheme et professionnalisation

    La FIFA indique que son programme d’investissement “Forward” pour 2023-2026 atteint USD 2,25 milliards, confirmant que la formation et le développement restent une priorité institutionnelle majeure. Cet afflux de moyens contribue à élever les standards d’encadrement, d’infrastructures et de compétitions, donc à densifier le vivier de joueurs “prêtables” et “promouvables”.

    La FIFA Talent Development Scheme est en phase d’implémentation et a déjà conduit à des académies talentueuses dans plusieurs confédérations. Concrètement, cela internationalise la production de talents et intensifie la concurrence : plus de régions peuvent former à haut niveau, et les clubs devront ajuster leurs stratégies de scouting, de partenariats et de prêts pour capter et développer ces profils.

    L’ouverture en 2026 d’une académie de talent au Kosovo, opérationnelle avec quatre jours de haute performance par semaine et football en club le week-end, illustre cette professionnalisation. On y retrouve une logique proche des environnements “high performance” : planification, charge maîtrisée, et articulation entre développement et compétition. Dans ce contexte, la promotion d’académie n’est plus un pari émotionnel, mais une sortie de pipeline conçue pour être reproductible.

    Les prêts et promotions d’académies redessinent donc l’équilibre des effectifs en combinant deux forces : une gestion dynamique des minutes (et du risque) et une monétisation plus fiable de la formation via des mécanismes FIFA plus transparents. Les chiffres de la chambre de compensation, près d’USD 1 milliard distribué depuis 2022, plus USD 221 millions liés aux joueurs appelés au Mondial 2026 et USD 768 millions hors participants, confirment que l’économie de l’académie a changé d’échelle.

    Pour les décideurs “tech-minded” (staff performance, direction sportive, analystes, opérateurs de ligue), l’enjeu est de traiter l’effectif comme un système : règles de prêts locales, observabilité des trajectoires, automatisation contractuelle, et investissement continu dans le développement. À l’image d’une infrastructure cloud, la performance durable vient moins d’un achat ponctuel que d’un pipeline bien instrumenté, capable de produire, déplacer et intégrer des ressources humaines au bon moment, au bon niveau et au bon coût.

  • Pourquoi l’oled pro adopté par PGL change les priorités des joueurs

    Pourquoi l’oled pro adopté par PGL change les priorités des joueurs

    Quand PGL annonce que le CS2 Major Singapore 2026 sera le premier Major Counter-Strike joué sur OLED, ce n’est pas un simple changement de fiche technique. Avec le ROG Swift OLED PG259QWS Ace comme moniteur officiel, l’écosystème compétitif signale que la performance ne se résume plus à « le plus de Hz possible », mais à une chaîne complète : image, réglages, reproductibilité et fiabilité en LAN.

    Pour les équipes, ingénieurs plateforme et organisateurs, cette bascule est surtout opérationnelle. Elle recompose les priorités autour de la constance du setup (d’une scène à l’autre), de la vitesse d’ajustement pré-match et d’une meilleure lisibilité en situation réelle,là où la latence d’entrée, la régularité du tracking et la stabilité mentale se jouent sur des détails.

    1) Le premier Major CS2 sur OLED : un basculement symbolique et pratique

    PGL présente le Major comme un « Major de premières » : première édition en Asie du Sud-Est et première scène principale sur OLED. Cette mise en scène compte, car elle valide publiquement une technologie longtemps jugée risquée pour l’usage tournoi (peur de rétention/burn-in, comportements variables selon l’éclairage, gestion du contraste).

    Dans les faits, l’adoption par un organisateur majeur agit comme un standard de marché. Les joueurs et staffs n’évaluent plus uniquement un écran comme un périphérique individuel, mais comme un élément d’infrastructure : quelque chose qui doit être reproductible, maintenable, et cohérent sur des dizaines de postes en LAN.

    Ce point est crucial pour les environnements compétitifs : un Major n’optimise pas « un joueur », il optimise un parc. L’OLED adopté par PGL change donc les priorités en introduisant une logique de standardisation et de process (pré-sets, contrôle, validation), au même titre que les politiques réseau, la topologie des serveurs ou la gestion des périphériques.

    2) 24,5 pouces, 1080p, 720 Hz : la vitesse ne suffit plus, mais elle reste un pilier

    Le PG259QWS Ace est un 24,5 pouces 1080p à 720 Hz, orienté esport. Le choix de la diagonale confirme une constante de Counter-Strike : la lisibilité du champ de vision, le contrôle périphérique et la cohérence de placement priment sur l’immersion. Un grand écran peut augmenter la charge de balayage visuel et dégrader la constance du geste.

    En parallèle, 720 Hz n’est pas un argument marketing isolé : c’est un signal que l’on cherche à réduire la friction perceptive dans le tracking (micro-corrections, flicks, transitions rapides). Mais le message implicite est plus nuancé : la vitesse brute est désormais intégrée dans un compromis plus complet « vitesse + contraste + lisibilité + confort visuel ».

    Dans une lecture pragmatique, cela rapproche l’écran d’un composant de performance comparable à la qualité d’un tickrate/frametime stable côté serveur : on ne veut pas seulement des pics, on veut une expérience régulière. Le changement de priorité vient de là : on valorise la cohérence de perception et d’exécution, pas uniquement la métrique maximale.

    3) TrueBlack Glossy Tandem WOLED : la lisibilité devient une variable compétitive

    La dalle TrueBlack Glossy Tandem WOLED met l’accent sur le contraste et la séparation des détails. Dans CS2, cette lisibilité peut se traduire par des repérages plus fiables (silhouettes, mouvements, variations fines dans les zones sombres), surtout quand l’action se joue sur des timings courts et des angles « borderline ».

    Ce n’est pas une promesse magique de « voir à travers les smokes » ou de contourner l’équité. C’est un gain de clarté dans des scènes complexes, là où la compression visuelle, la luminosité ambiante, et des réglages hétérogènes peuvent perturber la lecture. En tournoi, le sujet n’est pas de pousser des réglages agressifs, mais d’obtenir un rendu stable, contrôlable et identique pour tous.

    Pour des staffs techniques, la conséquence est directe : l’image devient un paramètre de performance à documenter. Comme on documente un profil réseau (jitter, routage LAN, politiques QoS), on documente un profil écran (modes couleur, gamma, luminosité, OSD) afin de minimiser l’incertitude entre practice room et scène.

    4) Un écran co-développé avec PGL et des pros : l’ergonomie et les workflows passent au premier plan

    ASUS indique avoir développé cet écran avec des retours directs de PGL et des meilleurs joueurs professionnels. Techniquement, cela veut dire que le hardware n’est plus « généraliste ». Il est pensé pour des contraintes concrètes : accès rapide aux réglages, positionnement du moniteur, stabilité du pied, et réduction du temps d’adaptation.

    Cette co-conception révèle un changement de priorité côté joueurs : moins de temps passé à « réapprendre » un setup, plus de temps passé à exécuter. En pratique, cela déplace la valeur compétitive vers des détails répétables : hauteur, inclinaison, distance, et presets visuels qui restent identiques d’un poste à l’autre.

    Pour les organisateurs, c’est aussi une évolution de gouvernance : les décisions matériel ne se limitent plus à « acheter le plus rapide ». Elles intègrent des critères de déploiement (consistance sur l’ensemble du plateau), de support (OSD, diagnostics), et de standardisation à l’échelle d’une saison, d’autant que PGL officialise un partenariat plus large avec ROG pour moniteurs, PC et périphériques.

    5) Position Sensor : la reproductibilité du setup devient mesurable

    Le “Position Sensor” qui affiche l’angle et les réglages physiques du moniteur formalise un besoin longtemps traité de façon artisanale. Les joueurs ont toujours cherché à reproduire leur position, mais la mesure était approximative (repères visuels, mémoire musculaire, marques adhésives).

    Avec un capteur et un affichage des paramètres physiques, on passe à une logique quasi-instrumentée : la reproductibilité devient contrôlable, donc auditable. Cela réduit la variance de confort et d’exécution entre deux matchs, entre la salle d’échauffement et la scène, ou entre deux jours d’événement.

    Et c’est là que « l’OLED adopté par PGL » change les priorités : l’avantage ne vient pas seulement des pixels, mais de la réduction des écarts. En compétition, minimiser l’inconnu est souvent plus rentable que gagner un avantage théorique difficile à exploiter sous stress.

    6) Pro Setting to Share, Esports Color modes et Quick OSD : priorité à l’ajustement pré-match

    La fonction “Pro Setting to Share” (export/import de réglages) transforme un geste individuel en workflow d’équipe. Un joueur peut stabiliser son rendu, le sauvegarder, le restaurer rapidement et même partager un preset dans un cadre maîtrisé (coaching, analystes, sessions de test).

    Les trois “Esports Color modes” et le Quick OSD vont dans la même direction : des ajustements rapides, contextualisés, réalisés juste avant un match plutôt qu’une configuration « unique et figée ». C’est particulièrement pertinent en LAN où les conditions peuvent changer (éclairage, caméras, fatigue visuelle, distance à l’écran).

    Pour les équipes techniques, cela ressemble à une standardisation de configuration comparable à l’infrastructure as code : on veut des profils reproductibles, déployables, et réversibles. Quand les réglages deviennent portables, on réduit le temps d’adaptation et le risque d’erreurs humaines,deux facteurs qui coûtent cher en tournoi.

    7) Fiabilité LAN : burn-in, refroidissement et politiques de maintenance redeviennent centrales

    L’OLED a longtemps été freiné par une priorité simple des pros : la fiabilité en événement. ASUS met en avant OLED Care Pro, un Neo Proximity Sensor, un refroidissement GaNFET et une garantie burn-in de 3 ans. Le message est clair : l’OLED doit être industrialisable pour un parc tournoi, pas seulement séduisant en usage domestique.

    Dans un Major, le coût d’un incident écran ne se mesure pas qu’en remplacement matériel. Il se mesure en interruptions, en re-checks, en contestations, en perte de rythme compétitif et en charge pour les arbitres et ingénieurs. La fiabilité devient donc une exigence de production, pas un bonus.

    Cette évolution remet aussi la maintenance au cœur du dispositif : cycles d’utilisation, gestion des pauses, procédures d’extinction/veille, contrôle des contenus statiques. Autrement dit, l’adoption de l’OLED par PGL pousse à penser « exploitation » autant que « performance », à l’image de la manière dont on gère un cluster de serveurs pour éviter les dérives (thermiques, pannes, saturation).

    8) Fragmentation des besoins : 360/540/560/720 Hz et fin du “meilleur écran universel”

    ASUS indique que ROG a travaillé avec PGL sur des modèles Ace OLED 24,5 pouces couvrant 360, 540, 560 et 720 Hz. Cela suggère un marché pro qui se fragmente : tous les joueurs ne cherchent pas le même compromis, et toutes les organisations ne déploient pas les mêmes contraintes budgétaires ou opérationnelles.

    Pour certains rôles et styles de jeu, la priorité peut rester la stabilité des FPS et la cohérence du pipeline de rendu. Pour d’autres, l’enjeu sera la lisibilité et la fatigue visuelle sur de longues journées. La conséquence : on passe d’un achat « one-size-fits-all » à une logique de profils, comme on choisit des instances différentes selon la charge (compute, memory, network) dans un hosting cloud.

    Dans un contexte PGL/ROG plus large (moniteurs, PC, périphériques pour la saison), l’objectif devient une plateforme matérielle standardisée mais modulable. Et cela change la manière dont les joueurs priorisent : ils optimisent moins “contre” le matériel, et davantage “avec” un environnement contrôlé et prévisible.

    Le fait marquant n’est pas seulement qu’un Major CS2 passe sur OLED ; c’est que cette adoption par PGL formalise de nouvelles priorités compétitives. La performance se lit désormais comme un système : image exploitable, réglages portables, position reproductible, fiabilité en LAN et standardisation à l’échelle d’un événement.

    Pour QuickFrag, la leçon est proche de celle qu’on observe côté serveurs et infrastructure : quand les fondamentaux (latence, stabilité, throughput) sont maîtrisés, l’avantage se déplace vers la réduction de variance. L’OLED pro adopté par PGL accélère précisément ce mouvement,en faisant de la constance du setup et du workflow un facteur de performance aussi tangible que les Hz.

  • Valve corrige la vitesse de wall-strafing et met à jour plusieurs cartes communautaires

    Valve corrige la vitesse de wall-strafing et met à jour plusieurs cartes communautaires

    La mise à jour Counter-Strike 2 du 19 août 2026 apporte un correctif discret en apparence, mais potentiellement déterminant en compétition : Valve indique avoir « Fixed a case where player speed was too high when moving against walls. » Autrement dit, la vitesse obtenue lors de certains déplacements contre les parois (wall-strafing) pouvait être anormalement élevée, et ce comportement a été corrigé.

    En parallèle, Valve a aussi rafraîchi des cartes communautaires en les alignant sur leur dernière version Workshop, notamment Boulder et Poseidon. Pour les équipes eSports, les organisateurs et les ingénieurs plateforme, ce double axe (mouvement + cartes) n’est pas anodin : il touche à la reproductibilité des situations, à l’entraînement, et à la stabilité des environnements serveur.

    1) Wall-strafing : ce que Valve a corrigé exactement

    La note officielle du 19 août 2026 mentionne un cas où la vitesse du joueur devenait « trop élevée » lorsqu’il se déplaçait contre des murs. Même sans détails d’implémentation, la formulation est claire : il ne s’agit pas d’un nerf global du mouvement, mais d’un cas limite (edge case) où la composante de vitesse pouvait dépasser l’attendu.

    Dans un FPS compétitif, ce type d’écart se traduit souvent par des timings légèrement cassés : un joueur atteint un angle plus tôt, un duel se joue sur un pixel d’avance, une punition devient impossible à cause d’un peek inhabituellement rapide. Cela affecte aussi la lecture des rounds, car l’adversaire doit « deviner » si une accélération est due au skill, au pathing, ou à un comportement physique exploitable.

    Pour les staffs techniques, ce patch réduit surtout la variance. Quand un mouvement « contre mur » donne parfois une vitesse supérieure, l’analyse vidéo et les retours de scrim deviennent moins fiables : on ne sait plus si l’écart provient d’une exécution ou d’une mécanique instable. En corrigeant ce cas, Valve rapproche la performance observée de la performance intentionnelle.

    2) Impacts compétitifs : timings, prises d’info et micro-positions

    Le wall-strafing rapide peut influencer des timings de prise d’info (jiggles, shoulder peeks, sorties de cover) et les reprises de lignes. Si certains murs permettent une accélération supérieure, des trajectoires « optimisées » apparaissent, souvent partagées en privé, puis reproduites en match officiel.

    La correction est donc susceptible de modifier des micro-référentiels : le moment exact où un CT arrive au contact d’un angle, la fenêtre pour lancer une flash anti-push, ou la possibilité de prendre un timing sur un rotate. Les équipes devront revalider des séquences d’ouverture, pas forcément toutes, mais celles dépendantes de rushes collés à des surfaces.

    Sur le plan tactique, la conséquence la plus saine est la réduction des « outliers ». Un jeu où quelques trajectoires offrent une vitesse non intentionnelle favorise l’optimisation mécanique sur des détails de collision plutôt que la décision. Le patch remet la priorité sur la lecture, la coordination et la discipline d’exécution.

    3) Subticks, tickrate et mouvement : pourquoi la discussion revient toujours

    La page officielle CS2 rappelle que le jeu repose sur les subticks et que le tickrate n’a plus d’influence sur les déplacements, les tirs et les lancers de grenades. C’est un point important pour interpréter ce correctif : il ne s’agit pas de « monter le tickrate » pour résoudre un problème de mouvement, mais bien de corriger une logique (ou une interaction) côté simulation.

    Dans les environnements eSports, on voit encore des diagnostics trop rapides : « c’est le serveur », « c’est la tickrate », « c’est le netcode ». Or, si un joueur gagne trop de vitesse en frottant une paroi, on est plutôt sur un cas de collision/physique/contrainte de mouvement qui s’exprime de manière cohérente à travers les conditions, indépendamment de la charge serveur (même si la charge peut compliquer l’observation).

    Pour les ingénieurs qui opèrent du cloud hosting, l’enjeu est d’éviter les faux positifs. Un patch mouvement peut changer la perception de la latence (« je me fais swing plus vite ») alors que le RTT n’a pas bougé. Il devient utile de tracer séparément : métriques réseau (RTT, jitter, loss) vs métriques gameplay (timings de contact, vitesses observées, distances parcourues par fenêtre temporelle).

    4) Cartes communautaires : Boulder et Poseidon mises à jour via le Workshop

    Le même 19 août 2026, Valve a mis à jour des cartes communautaires vers leur dernière version Workshop : Boulder et Poseidon. En pratique, cela signifie que la version distribuée en jeu suit désormais la révision la plus récente publiée par les créateurs sur le Workshop, plutôt qu’une build antérieure.

    Pour les organisateurs et les rédactions eSports, c’est un détail à traiter comme un changement de règles : une « même » carte peut avoir des différences de lineups, de boosts, de clipping, de lisibilité ou de comportements de projectiles. Les notes de Valve évoquent d’ailleurs, plus largement, des correctifs de cartes incluant des gaps, des ajustements de collision et d’autres corrections de niveau/carte.

    Du point de vue infrastructure, la mise à jour Workshop implique aussi une discipline de versioning côté serveurs. Si vos nœuds de scrim ou vos serveurs de qualifs utilisent des collections Workshop, il faut verrouiller (pin) une version ou orchestrer une fenêtre de mise à jour contrôlée, sous peine d’avoir des environnements divergents entre l’entraînement et la compétition.

    5) Gaps, collisions et « petits » correctifs : gros effets sur la compétition

    Les notes mentionnent des problèmes de cartes corrigés, notamment des gaps et des ajustements de collision. Dans Counter-Strike, ce sont rarement des détails : un gap peut offrir un angle one-way involontaire, un pixel-walk, une ligne de tir imprévue ou une zone où une smoke fuit.

    Les collisions sont encore plus critiques. Un changement de collision peut casser un jump, empêcher un boost, modifier une trajectoire de grenade, ou permettre au contraire une position plus stable. Pour les équipes, cela se répercute immédiatement sur les playbooks : set-ups de retake, positions anti-exec, chemins de rotate « safe ».

    Pour les admins et les plateformes, la leçon est qu’un patch « cartes » doit être traité comme un patch gameplay. Un protocole minimal consiste à : (1) régénérer les replays de tests, (2) revalider les lineups clés (smokes/molos), (3) vérifier les zones critiques de collision (boosts, rampes, coins), et (4) documenter les diffs pour les équipes.

    6) Une stratégie continue sur les cartes communautaires (juillet,août 2026)

    Le correctif du 19 août 2026 s’inscrit dans un contexte où Valve a déjà ajouté ou retiré plusieurs cartes communautaires du pool de jeu en juillet et août 2026. On a notamment vu passer Boulder, Fachwerk, Shelter, Debris, El Dorado, ainsi que Warden, Stronghold, Alpine et Sanctum.

    Pour un écosystème compétitif, cette rotation a deux effets opposés. Côté positif : elle renouvelle les terrains d’entraînement, offre des cartes plus « propres » si les mises à jour corrigent la clarté et la qualité, et pousse l’innovation tactique. Côté négatif : elle augmente le coût de maintenance (docs, VOD, antistrats) et la charge de validation technique.

    Valve indique d’ailleurs sur le site officiel CS2 que des mises à jour et améliorations sont apportées aux cartes pour les rendre plus nettes, plus claires et de meilleure qualité. Pour QuickFrag, l’enjeu est d’aligner cette intention avec l’opérationnel : plus de clarté en jeu, mais aussi plus de rigueur dans le cycle de déploiement et la communication des changements.

    7) Le mouvement comme sujet récurrent : le précédent du 24 septembre 2025

    Ce n’est pas la première fois que Valve intervient sur des comportements de déplacement. Le 24 septembre 2025, un patch corrigeait déjà un problème lié à l’input et au mouvement : « you couldn’t start moving while wiggling the mouse. » Même si la nature exacte diffère, la constante est la même : des cas limites d’interaction (input/simulation) peuvent créer des avantages ou des frustrations.

    En compétition, ces cas limites deviennent rapidement des « techniques » : certains les considèrent comme de l’optimisation, d’autres comme de l’exploitation. La frontière est mouvante, et Valve tranche généralement via des correctifs ciblés, comme ici sur la vitesse trop élevée contre mur.

    Pour les staffs performance, ces antécédents suggèrent une démarche : surveiller activement les patch notes officiels (source primaire), et maintenir un changelog interne orienté impact (mouvement, collisions, timings, lineups), plutôt qu’un simple résumé généraliste.

    Au final, la mise à jour du 19 août 2026 est un rappel : un seul correctif de mouvement, en l’occurrence la vitesse de wall-strafing trop élevée dans certains cas, peut avoir des effets en chaîne sur les timings, les duels et la perception de la « vitesse » en match, sans que la latence réseau ait changé.

    Et en mettant à jour Boulder et Poseidon via le Workshop, tout en corrigeant des gaps et collisions, Valve confirme une cadence d’itération sur les cartes (surtout communautaires) qui impose une discipline côté équipes et organisateurs : contrôle de versions, procédures de validation, et communication claire pour éviter que l’infrastructure et la compétition ne divergent.

  • Jouer 5v5 compétitif sans client lourd : serveur dédié prêt en moins d’une minute

    Jouer 5v5 compétitif sans client lourd : serveur dédié prêt en moins d’une minute

    En 2026, le “ready in under a minute” n’est plus une promesse marginale : c’est devenu un positionnement commercial récurrent dans le game hosting. Pour les équipes eSports et les organisateurs, l’intérêt est évident : réduire au minimum le temps entre l’inscription, le choix de la région et le lancement d’un match 5v5 compétitif, notamment sur Counter-Strike 2, sans dépendre d’un client lourd côté admin ou d’une machine locale surdimensionnée.

    Cette accélération n’est pas qu’un confort. Elle influence directement l’exploitation (ops), la planification des scrims, la capacité à lancer des retakes ou des workshop maps à la demande, et la résilience en compétition (remplacement d’un serveur, montée en charge, bascule régionale). Un serveur dédié prêt en moins d’une minute devient un outil de cadence : on joue plus vite, mais surtout on itère plus vite, avec une latence et une stabilité réseau maîtrisées.

    1) Pourquoi le “moins d’une minute” change la dynamique du 5v5 compétitif

    Dans un environnement 5v5, chaque minute “hors jeu” est un coût : joueurs mobilisés, staff en attente, créneau d’entraînement qui glisse, et parfois perte de focus. Les hébergeurs qui annoncent un serveur dédié CS2 “prêt à jouer” en moins d’une minute ciblent précisément cette friction entre intention (lancer un match) et exécution (avoir un serveur opérationnel).

    La tendance marché confirme la demande : en 2026, plusieurs offres affichent explicitement des promesses de mise en service en < 60 secondes. Ce n’est pas seulement du marketing : c’est le reflet d’une concurrence sur le provisioning (création, assignation de ressources, réseau, sécurité) qui se déplace au même niveau d’importance que le ping ou la protection DDoS.

    Pour l’organisation d’un compétitif 5v5, le bénéfice est aussi logistique : on peut multiplier les environnements. Un serveur “scrim”, un serveur “strats”, un serveur “aim/retake”, voire un serveur “always-on” pour la communauté, sans devoir planifier des jours à l’avance ni immobiliser une machine pendant des heures.

    2) “Sans client lourd” : ce que cela implique vraiment côté équipe et côté infra

    Dire “sans client lourd” ne signifie pas “sans logiciel”, mais “sans dépendance à une workstation admin puissante” et sans installation complexe pour orchestrer le serveur. Le modèle moderne privilégie un contrôle via panel web, API, ou images préconfigurées, avec une exécution dans un datacenter optimisé. Les opérations (création, restart, changement de map) se font à distance, avec des workflows reproductibles.

    Cette logique est cohérente avec l’évolution du cloud gaming : on déporte le calcul et l’autorité du jeu vers des serveurs distants, et on exige une connexion à faible latence plutôt qu’une machine locale musclée. Pour du compétitif, l’objectif est double : standardiser l’environnement (cvars, tick/paramètres, plugins autorisés) et réduire la variance matérielle.

    Concrètement, pour une équipe eSports, cela facilite l’industrialisation : templates par jeu/mode, variables par tournoi, et déploiements identiques entre staff. Pour un organisateur, c’est la capacité à instancier des serveurs “propres” par match, à limiter les dérives de configuration, et à isoler les incidents (un match n’impacte pas les autres).

    3) Le secret du provisioning express : pools chauds, conteneurs et session-based gaming

    Atteindre “prêt en moins d’une minute” repose rarement sur une VM créée de zéro. Le pattern dominant est le préchauffage : pools chauds (warm pools), images prêtes, et placement rapide. Gameye illustre cette approche orientée session-based gaming en annonçant des sessions démarrées en 0,5 seconde, grâce au placement de conteneurs, aux pools chauds et au cloud bursting.

    Dans une architecture “session-based”, on ne raisonne plus uniquement en serveurs longs (always-on) ; on raisonne en sessions éphémères à forte cadence. C’est idéal pour des scrims ou des blocs d’entraînement : on démarre, on joue, on détruit, tout en conservant les artefacts utiles (logs, démos, configs) dans un stockage persistant.

    Les mesures publiques vont dans le même sens : certains comparatifs rapportent des temps de démarrage très bas (par exemple 6,2 secondes en cold start observées sur un environnement Garry’s Mod). Même si chaque jeu a ses contraintes, cela prouve que le “démarrage rapide” est techniquement atteignable lorsque l’infra (images, réseau, orchestration) est pensée pour.

    4) Serveur dédié = autorité, cohérence et performance (et pas seulement “plus de puissance”)

    Un dedicated game server est conçu pour être l’autorité des événements multijoueurs : validation des actions, synchronisation, gestion des états, anti-triche côté serveur quand applicable, et cohérence des règles. C’est un point clé en 5v5 compétitif : le serveur doit être la référence, pas un client hébergeant la partie.

    Le bénéfice pragmatique est la réduction de l’aléatoire. Quand le serveur vit dans un datacenter, sur un matériel stable, avec des politiques réseau et des profils CPU maîtrisés, on réduit les sources de variance (processus locaux, throttling, congestion Wi‑Fi). En compétition, ce sont ces détails qui transforment un “ping correct” en expérience réellement stable.

    Enfin, la notion de “serveur prêt” ne doit pas masquer l’exigence de reproductibilité : même version, mêmes libs, mêmes paramètres, mêmes scripts de démarrage. Les environnements 5v5 cités en 2026 mettent en avant la compatibilité avec competitive 5v5, scrims, retakes, workshop maps et serveurs always-on, signe que l’offre n’est pas seulement “rapide”, mais aussi alignée sur les usages compétitifs.

    5) Latence et stabilité : la vraie baseline d’un 5v5, même avec un provisioning instant

    Le provisioning en < 60 secondes est utile uniquement si la latence est au rendez-vous. Les pages de hosting dédiées aux jeux continuent de marteler les fondamentaux : matériel rapide, datacenters européens, protection DDoS, et revendications de faible ping. Pour du 5v5 compétitif, ce sont des critères non négociables.

    Sur le plan infra, il faut regarder au-delà du ping “moyen” : jitter, perte de paquets, stabilité inter-FAI, et capacité à encaisser les pics (warmup, changement de map, overtime). Le “serveur prêt” doit aussi être “serveur stable”, sinon on échange un gain de temps initial contre des interruptions en match.

    Pour les organisateurs, cela se traduit en exigences opérationnelles : régions fixes, routes testées, procédures de bascule, et observabilité. Idéalement : métriques réseau, charge CPU, événements DDoS, et logs exploitables rapidement. Le compétitif 5v5 est impitoyable : une dégradation subtile suffit à impacter l’exécution tactique.

    6) Matériel et instances 2026 : densité de sessions, démarrage rapide et perf réelle

    L’optimisation matérielle reste un différenciateur majeur en 2026, précisément parce que les workloads “session-based” multiplient les démarrages et les pics courts. AWS a publié en juillet 2026 un billet sur des instances m8azn orientées hébergement multijoueur, en mettant en avant des gains pour les serveurs à démarrage rapide et les jeux à forte densité de sessions.

    Dans la pratique, cela veut dire que le choix du CPU, la performance single-core, la fréquence soutenue, et la politique de contention (noisy neighbor) peuvent être plus déterminants que la quantité brute de RAM. Un serveur CS2 5v5 n’a pas les mêmes contraintes qu’un serveur moddé à 64 slots : l’objectif est la constance, pas le maximum théorique.

    À l’échelle d’une plateforme, la densité de sessions devient un KPI : combien de matchs simultanés par nœud, avec quelle marge de sécurité, et quel temps de re-provision en cas d’incident. C’est ici que le “prêt en moins d’une minute” doit être corrélé à des SLOs (disponibilité, latence, taux d’échec de démarrage), pas seulement à un chrono marketing.

    7) Coûts, volatilité tarifaire et risques : ce que le “instant dedicated” ne dit pas

    Le marché est actif, mais les coûts ne sont pas stables. TechRadar rapporte qu’OVHcloud a signalé une hausse de prix d’environ 87% à partir de septembre 2026 sur certaines offres, y compris gaming. Pour une équipe ou un organisateur, cela peut changer le modèle : always-on vs à la demande, ou consolidation régionale.

    Le “instant dedicated” peut aussi cacher des arbitrages : sur-allocation, limites de CPU, priorités de placement, ou restrictions réseau selon les gammes. Une promesse “ready in under 60 seconds” (comme celle annoncée par Skånehost dans le hosting grand public) indique que le provisioning express se généralise, mais ne garantit ni la qualité de routage, ni la stabilité en charge, ni la transparence des quotas.

    La recommandation pragmatique : contractualiser des métriques, tester en conditions réelles, et comparer le coût total. Inclure : bande passante, DDoS, snapshots/templates, stockage des démos, support en incident match-day, et éventuels frais de sortie. En compétitif, le prix du serveur n’est qu’une ligne ; le prix de l’arrêt de match est le vrai risque.

    Le serveur dédié prêt en moins d’une minute s’impose en 2026 parce qu’il répond à une réalité opérationnelle : le compétitif 5v5 exige de la vitesse d’exécution, de la standardisation, et une capacité à relancer vite, sans mobiliser une infra locale ni des procédures lourdes. Les architectures modernes (conteneurs, pools chauds, cloud bursting) rendent cette promesse techniquement crédible, et les offres CS2 l’alignent explicitement sur les usages scrim/retake/workshop/always-on.

    Mais l’instantané ne remplace pas les fondamentaux : latence, jitter, anti-DDoS, perf CPU soutenue, observabilité et discipline de configuration. Pour les équipes eSports et les organisateurs, l’objectif n’est pas seulement de démarrer en 60 secondes ; c’est de garantir que chaque round se joue sur un terrain réseau et serveur aussi neutre, stable et reproductible que possible.

  • Coordonner les utilitaires après l’IEM Cologne : rotations, synchronisation et signaux pour dominer

    Coordonner les utilitaires après l’IEM Cologne : rotations, synchronisation et signaux pour dominer

    Après IEM Cologne 2026, la coordination des utilitaires est redevenue un sujet prioritaire dans le meta CS2. Ce n’est pas seulement une question de « bonnes smokes » : Valve rappelle que les smokes sont volumétriques et réactives, que les HE peuvent pousser la fumée, et que le moteur sub-tick enregistre précisément l’instant du lancer. Résultat : les timings de setup sont plus fiables, et les erreurs de synchronisation sont plus visibles (et plus punies).

    Dans un tournoi au format long et exigeant,32 équipes, trois phases suisses puis élimination directe selon HLTV,les équipes qui ont dominé sont celles qui ont su faire coïncider rotations, information et utilitaires sur des séries de matches entières. Pour les staffs, ingénieurs et analystes, l’enjeu est double : formaliser des protocoles reproductibles et les rendre robustes aux variations (latence, pression, adaptations adverses).

    1) Ce que Cologne 2026 a réellement “validé” : utilitaire + rotation comme système

    Cologne 2026 a servi de vitrine à une approche « utility first » : prise d’espace, limitation de l’info adverse, et fenêtres de timing créées par flash/smoke/molo. HLTV a insisté sur le fait que les rotations CT et les timings de soutien pouvaient faire basculer un match, ce qui déplace le focus du simple duel vers l’orchestration.

    Dans CS2, l’utilitaire n’est plus un décor statique. Les smokes dynamiques réagissent à l’environnement, et la possibilité de « sculpter » brièvement une ligne de vue via une HE qui pousse la fumée rend les micro-fenêtres d’action centrales : on ne « prend » plus une zone, on la prend pendant 0,5 à 1,5 seconde au bon moment.

    La conséquence pragmatique pour une équipe compétitive : vos rotations ne doivent pas être déclenchées uniquement par des calls « je sens B ». Elles doivent être attachées à des signaux observables (utilitaire entendu/seen, timings de contact, absence de pression) et à des engagements utilitaires pré-établis (qui flash, qui molly, qui retarde), sinon vous rotaterez trop tôt ou trop tard.

    2) Sub-tick et précision : synchroniser “au millimètre” devient une compétence

    Valve met en avant le sub-tick : le serveur enregistre l’instant exact où une grenade est lancée. Pour la coordination, cela réduit la variabilité introduite par les repères purement “tick-based” et rend les exécutions synchronisées plus consistantes… à condition d’avoir des calls et des routines de lancement propres.

    Concrètement, cela favorise des enchaînements stricts du type « smoke (t=0), flash pop (t=+0,35), HE push smoke (t=+0,55), peek (t=+0,65) ». En CS:GO, ces timings étaient souvent approximés à l’oreille et au feeling. En CS2, vous pouvez les calibrer, les répéter, et surtout les auditer en démo avec une granularité plus utile pour le coaching.

    Côté infrastructure (serveurs d’entraînement, environnements cloud, scrims), l’objectif devient de minimiser les sources d’écart qui brouillent l’apprentissage : jitter, pertes, ou variations de latence entre joueurs. La synchro sub-tick est un avantage seulement si l’environnement est stable ; sinon, les joueurs compensent “à la main” et détruisent la reproductibilité des setups.

    3) Rotations CT : déclencher le bon soutien au bon timing

    HLTV a noté qu’à Cologne 2026, certains joueurs ont trouvé une nouvelle valeur dans des rôles de rotation CT plus supportifs. Le principe : un CT ne “rotate” pas seulement avec un rifle, il rotate avec un paquet utilitaire et une mission (retard, reprise d’info, anti-exec).

    Une rotation CT efficace suit une logique de synchronisation : (1) un ancrage qui temporise, (2) un joueur info qui confirme l’intention T, (3) un soutien qui arrive avec flash/HE/molo pour casser le tempo adverse. Sans ce triptyque, vous arrivez soit trop tôt (et vous vous exposez à un re-contact), soit trop tard (et vous retakez sans ressources).

    BIG illustre bien cet équilibre entre rôles, utilitaires et rotations CT : HLTV relève chez tabseN 4,98 utility ADR et 0,81 flash thrown par round, avec un rôle plus supportif. Pour un IGL, c’est un modèle : faire coïncider prise d’info, flashs et timing de rotation, plutôt que d’empiler des déplacements sans couverture utilitaire.

    4) Flashs et “fenêtres de passage” : ce que disent les chiffres (M80, Astralis, Spirit, Lynn Vision)

    Les stats Cologne 2026 réaffirment une réalité opérationnelle : la flash n’est pas un bonus, c’est un signal d’exécution et un multiplicateur de rotation. M80 a été mis en avant par HLTV pour 0,33 flash assists par round, co-meilleur parmi les équipes de Major 2026 avec Astralis,un indicateur direct de coordination et de discipline de timing.

    Spirit est un autre repère, car leur progression est corrélée à la structure : HLTV mentionne 0,28 flash assists par round avec S0tF1k contre 0,25 avec hally en 2026, et 0,18 en 2025 sous chopper. Ce type d’évolution suggère que la synchronisation des flashes est un produit de protocole (noms de throws, fenêtres de peek, priorités de trade), pas seulement de “talent mécanique”.

    Lynn Vision, décrite comme l’équipe la plus “flash-heavy” de la galerie Cologne, monte à 0,37 flash assists par round (HLTV). C’est un cas d’étude utile : une agressivité durable dépend moins de l’audace que de la cadence d’aveuglement et du respect des timings (si la rotation arrive 0,3 seconde après la pop-flash, l’avantage disparaît).

    5) Séquences modernes : smoke volumétrique, HE qui pousse, et peek synchronisé

    Valve rappelle que les HE peuvent pousser la fumée et ouvrir brièvement des lignes de vue. Après Cologne, la séquence « flash + HE + peek » devient une arme pour dominer les rotations adverses : vous punissez un CT qui s’est replacé “safe” derrière une smoke, ou vous forcez un anchor à révéler sa position par nécessité.

    Pour l’équipe, le point critique est la synchronisation : la HE doit arriver dans la bonne phase de densité de la smoke, et le peek doit exploiter la fenêtre créée avant que l’adversaire ne réagisse. Cela impose des signaux simples et stables (comptage vocal, top HUD, repères sonores) plutôt que des calls bavards.

    En pratique, vous gagnez en fiabilité si vous standardisez : (a) le lanceur d’HE est aussi le « timekeeper », (b) le peeker annonce “ready” avant le lancer, (c) le joueur flash ne “corrige” pas à la dernière seconde. Cette rigidité est compatible avec CS2 : le sub-tick récompense les routines propres, et expose les improvisations.

    6) Post-plant et retake : l’interaction bombe/smoke change les priorités de rotation

    Le patch CS2 du 20 juillet 2026 indique que l’explosion de la bombe interagit désormais avec les nuages de smoke et les feux de molotov/incendiary. Cette interaction change la valeur de certains setups post-plant et, surtout, les timings de retake : une smoke “théorique” peut devenir moins fiable dans la fenêtre proche de l’explosion.

    Pour une rotation CT, cela signifie que vos protocoles doivent intégrer un axe temporel supplémentaire : « combien de temps avant l’explosion ? » et « quelle utilité risque d’être dégradée ? ». Certaines équipes vont privilégier des retakes plus tôt (avant que la configuration ne se déstabilise), d’autres vont jouer le désamorçage avec une redondance utilitaire (double smoke, flash de reprise, ou contrôle des feux).

    Côté T, cela ouvre des plans pragmatiques : sécuriser des positions qui restent fortes même si une smoke se dissipe ou se perturbe, et conserver une flash pour le moment où le CT doit sortir d’un cover devenu incertain. Le point important : la coordination des utilitaires doit être liée au chrono de bombe, pas uniquement au placement.

    7) Signaux, protocoles et production : rendre la coordination lisible (in-game et hors-game)

    Les signaux de timing restent fondamentaux : avec le sub-tick, les calls synchronisés sont plus fiables que des repères approximatifs. Une bonne pratique consiste à réduire le langage à des “signaux d’état” : ready / set / go, ou des codes par utilitaire (S1, F2, H1) mappés sur des throws connus en stratbook.

    Les patchs post-Cologne montrent que l’écosystème suit : le 29 juillet 2026, Valve a ajouté r_spectator_flashbang_opacity, indiquant que la lisibilité des flashes devient aussi un sujet spectateur/production. Pour des organisateurs et équipes média, une meilleure lecture de l’utilitaire améliore la compréhension des timings de rotation, donc la narration et l’analyse.

    Le patch du 19 août 2026 ajoute CSGrenadeType et des changements liés au flash/smoke : signe que la logique des grenades continue d’évoluer après Cologne. Implication opérationnelle : vos scripts d’analyse (tags utilitaires en démo, dashboards, alerting sur patterns) et vos signaux d’exécution doivent être recalibrés régulièrement, sinon votre “discipline” devient obsolète malgré de bons principes.

    Coordonner les utilitaires après IEM Cologne 2026 revient à traiter la grenade comme un événement synchronisé, pas comme une ressource individuelle. Entre smokes volumétriques, HE qui poussent la fumée et sub-tick, CS2 récompense les équipes capables de transformer des timings en procédures reproductibles, auditables, et adaptables sur une longue compétition.

    Les chiffres (M80/Astralis à 0,33, Spirit en progression structurelle, Lynn Vision à 0,37) et les exemples de rôles support (BIG/tabseN) pointent tous vers la même conclusion : rotations, synchronisation et signaux ne sont pas des “détails”, mais un système. Pour dominer, il faut aligner l’infrastructure (stabilité), le coaching (protocoles) et l’exécution (timings) afin que chaque flash, smoke et HE déclenche une décision collective au bon moment.

  • La refonte des explosions change la prise d’angles et l’économie des rounds

    La refonte des explosions change la prise d’angles et l’économie des rounds

    Dans un FPS compétitif, une “refonte des explosions” n’est pas un simple ajustement d’effets visuels : c’est une modification de la manière dont les équipes contestent l’espace, cassent des setups défensifs et convertissent un avantage en round gagné. Dès qu’un explosif change (dégâts, rayon, timing, VFX, audio, fiabilité), la prise d’angles évolue mécaniquement, parce que la menace qui punit un joueur “posté” n’est plus la même.

    Chez QuickFrag, on s’intéresse à l’impact tactique, mais aussi à ce que cela implique côté infrastructure et exploitation compétitive : la lisibilité (audio/VFX) et la cohérence (timings, interactions) conditionnent la qualité des décisions et la reproductibilité des rounds en match et en scrim. Les notes Riot sur les utilitaires “angle-breaking” (patch 1.09), les ajustements d’explosifs de Raze (mai 2025), ou encore la priorité donnée à la communication via l’audio (patch 13.05, septembre 2026) dessinent une même direction : faire payer les angles trop forts, sans rendre le jeu illisible ni économiquement instable.

    1) Explosifs et prise d’angles : la doctrine “angle-breaking” de Riot

    Riot a posé noir sur blanc, dès les patch notes 1.09, que certaines capacités existent pour “take angles” et créer de la pression sur les joueurs déjà en position. C’est un point fondamental : l’angle n’est pas seulement un duel de visée, c’est une interaction entre une ligne de vue, un timing, et une utilité qui force un déplacement, un recul, ou un trade défavorable.

    Quand un explosif est retouché, on modifie précisément ce levier de pression. Un rayon légèrement réduit, un délai d’armement différent, une explosion plus lisible, ou un son mieux atténué changent la probabilité que le défenseur “tienne” l’angle, ou qu’il se fasse déloger sans échange. En pratique, cela recompose la hiérarchie des angles “rentables” : ceux qu’on peut tenir sans être forcé, et ceux qu’on doit abandonner dès la première info d’utility.

    Ce cadre explique pourquoi les “refontes” d’outils explosifs ont un effet plus large que le simple pick d’un agent. Elles touchent la dynamique des entrées (entry), la structure du mid-round (re-clears), et les reprises (retake). Si l’utility explosive devient plus fiable, on voit plus de prises d’angles agressives ; si elle devient plus coûteuse (en économie ou en opportunité), on voit davantage de rounds joués sur l’info et le bait d’utility.

    2) Tejo Rework (mars 2026) : un cas concret de refonte qui rebat le tempo

    En mars 2026, Riot a indiqué qu’un Tejo Rework était en cours après la découverte d’un exploit. Au-delà du correctif, le signal est clair pour les équipes : une refonte d’agent peut modifier la façon d’occuper l’espace, de forcer les angles, et de “lancer” un round. Dès qu’un kit change, les timings standard (prise de mid, contact sur choke, re-peek) doivent être revalidés.

    Ce type de refonte agit souvent sur la cohérence des interactions (Riot parle régulièrement de “consistency” et de “balance”). Or, la cohérence est un multiplicateur tactique : si un explosif/outil de rupture d’angle se comporte de manière plus prévisible, on peut planifier des prises d’angles à haute fréquence avec une variance réduite. À l’inverse, si la refonte retire une option trop forte, les équipes doivent compenser par des combos plus coûteux (double util, plus de présence, ou un sacrifice de tempo).

    Dans un environnement compétitif, l’effet le plus immédiat est le “tempo shift” : soit l’attaque peut reprendre l’initiative plus tôt (forcer le recul, prendre une ligne de vue sans dry peek), soit la défense regagne du temps (tenir plus longtemps, consommer moins d’utility). Ce tempo se traduit directement en économie de round : plus de tempo côté attaque = plus de conversions propres ; plus de tempo côté défense = plus d’attrition, donc plus d’achats cassés et de sauvegardes.

    3) Raze et la lisibilité : pourquoi les VFX d’explosion changent les duels d’angle

    En mai 2025, Riot a explicitement modifié les VFX d’explosion de Raze pour Boom Bot et Paint Shells. Ce n’est pas anecdotique : la lisibilité visuelle d’une explosion détermine la vitesse à laquelle un joueur peut décider “je hold”, “je décale”, “je re-peek après”, ou “je joue anti-flash/anti-utility”.

    Dans un duel d’angle, une explosion sert souvent à créer une fenêtre d’action asymétrique : le défenseur recule (ou subit), l’attaquant avance (ou prend une ligne). Si les VFX sont plus clairs, la défense identifie plus vite la menace et choisit un repositionnement optimal ; si les VFX sont moins ambigus, l’attaque sait mieux si l’explosif a réellement “ouvert” l’angle ou s’il faut recommit avec une seconde utilité.

    Pour les staffs techniques et organisateurs, c’est aussi une question de qualité de signal en match : les erreurs de lecture (un joueur pense être “safe” derrière une information visuelle trompeuse) coûtent des rounds, donc faussent la mesure de performance. Les ajustements VFX sur des explosifs très présents comme ceux de Raze illustrent que Riot continue d’affiner la manière dont les dégâts de zone “ouvrent” les lignes de vue et forcent les joueurs à céder ou reprendre un angle.

    4) Économie des rounds : l’explosion comme outil de “risk management”

    Riot a directement relié prise d’angles et économie dans les patch notes 1.09, notamment via le rééquilibrage de l’Operator : retarder son apparition et augmenter la pénalité de mourir avec met en évidence le “risk/reward” d’une arme premium tenue sur un angle. Dès que l’économie punit davantage la mort avec une arme chère, la valeur d’un outil qui casse cet angle augmente.

    Une refonte des explosions change donc la comptabilité implicite d’un round. Si un explosif rend un angle Operator moins tenable (plus de force de délogement, meilleure fiabilité, meilleure lisibilité), l’Operator devient un investissement plus risqué sur certaines positions et plus intéressant sur d’autres (angles plus profonds, lignes de repli). Inversement, si l’explosif est nerfé (rayon, dégâts, timing), l’Operator retrouve des positions “stables”, et l’attaque doit dépenser plus d’utility pour atteindre le même résultat.

    On retrouve ici la thèse pragmatique : “refonte des explosions = plus de responsabilité sur l’utility commit”. L’explosif doit justifier son coût (crédits, slot, opportunité) en générant un gain tangible : déplacement forcé, info, ou conversion (kill/space). S’il ne le fait pas, l’économie des rounds se déséquilibre : soit l’attaque surpaye l’entrée, soit la défense sur-rentabilise des positions fortes.

    5) Audio, communication et décisions économiques : l’impact caché de la lisibilité

    En septembre 2026, les patch notes 13.05 ont ajusté l’atténuation sonore des sprays pour “ensure teams can communicate effectively”. Même si cela ne vise pas exclusivement les explosions, le message est net : la communication et la lisibilité audio sont prioritaires, parce qu’elles conditionnent des décisions en temps réel,dont les prises d’angles et les commits d’utility.

    Pourquoi est-ce économique ? Parce qu’une meilleure lecture audio/visuelle réduit les erreurs de commit. Une équipe qui identifie correctement qu’une explosion a forcé un repositionnement (ou non) évite de “double investir” inutilement. À l’échelle d’une map, cela se transforme en cycles d’achat plus sains : moins de rounds gaspillés sur des exécutions mal lues, plus de conversions sur les rounds clés (bonus, anti-eco, et gun rounds serrés).

    Côté infrastructure et production eSports, la lisibilité a aussi une dimension de standardisation : quand les signaux audio sont plus cohérents, la marge d’ambiguïté diminue entre environnements (LAN vs online, casques, mixage). Cela ne remplace pas une bonne gestion de latence, mais cela limite le nombre de décisions “fragiles” où un micro-écart d’info peut renverser un duel d’angle,et donc la valeur réelle des achats.

    6) Retake (2026) : le laboratoire “sans économie” pour mesurer la valeur des explosions

    Le mode Retake introduit en 2026 est décrit comme “No economy”. C’est un outil de comparaison particulièrement utile : en l’absence d’économie, la logique des prises d’angles change totalement, parce que le coût de mourir (ou de surinvestir en utilité) n’a plus de conséquence au round suivant.

    Dans Retake, le spike est déjà planté et la reprise se joue sous timer : les explosifs et l’utility de rupture d’angle deviennent des accélérateurs de décision. On ne “protège” pas une arme premium pour la manche suivante, on optimise l’espace et le temps. Cela met en relief ce que l’économie masque parfois en match classique : certaines explosions valent surtout par le tempo et la capacité à forcer un angle immédiatement, pas seulement par la létalité.

    Pour des équipes et ingénieurs de plateforme, Retake sert aussi à isoler des variables : si une refonte d’explosif améliore la lisibilité et la cohérence, on doit observer des reprises plus structurées et moins de deaths “incompréhensibles”. Ensuite, en réintroduisant l’économie (modes compétitifs), on peut mesurer comment cette même refonte modifie la fréquence des sauvegardes, la propension à tenir des angles chers (Operator) et le pourcentage de conversions sur les rounds pivot.

    7) Patch cadence et organisation : préparer les playbooks et la stabilité de compétition

    Les changements de Tejo s’inscrivent dans un contexte où Riot ajuste régulièrement l’équilibre tactique des rounds : la note de patch 12.06 mentionne aussi des ajustements de gameplay, confirmant que les refontes ne sont pas seulement cosmétiques. Pour les staffs, cela impose une discipline : versioning des playbooks, scrims orientés “angles”, et mises à jour rapides des standards d’utility.

    Une refonte des explosions demande un audit pragmatique : quels angles deviennent intenables ? Quels setups défensifs exigent désormais une double utilité ? Quels timings d’entrée gagnent en valeur ? La bonne approche est de traiter l’explosif comme une ressource économique : on documente le “cost to clear” d’un angle (1 util, 2 utils, ou dry), puis on relie cela aux plans d’achat (full buy, light buy, bonus).

    Enfin, pour les organisateurs et équipes techniques, la stabilité de compétition se joue aussi sur la clarté des comportements patchés. Quand Riot met l’accent sur la “consistency” et la communication (audio), cela facilite la standardisation des règles de tournoi, la préparation des équipes, et la réduction des litiges. Une refonte bien instrumentée (notes claires, comportements observables) aide à aligner tactique, économie, et intégrité compétitive.

    La refonte des explosions change la prise d’angles parce qu’elle touche le cœur du contrôle territorial : forcer un déplacement, créer une fenêtre de peek, ou rendre une position coûteuse à tenir. Les exemples récents et structurants,Tejo Rework (mars 2026), VFX de Raze (mai 2025), doctrine “angle-breaking” (1.09), et priorité à la lisibilité audio (13.05),montrent une ligne directrice : rendre les échanges plus lisibles, mais aussi plus justement “payants”.

    Sur le plan de l’économie des rounds, l’équation est simple : plus l’explosif est fiable et lisible, plus il devient une alternative rentable au duel “brut” contre des armes fortes sur angle (Operator en tête), et plus il influence les cycles d’achat, les sauvegardes et les conversions. Pour les équipes, ingénieurs et organisateurs, la meilleure réponse est méthodique : mesurer l’effet sur les angles clés, réécrire les playbooks, et exploiter des formats comme Retake (sans économie) pour isoler la valeur réelle des explosions avant de la traduire en décisions d’achat en match compétitif.